拓扑排序

闲庭信步

没错,这次是关于某个叫作 "拓扑排序" (Topological sorting) 的图论算法, 通过已经知道了的话, 那么这篇文章就可以忽略了. (总之绝对不是水平太烂了, 导致只能当复读机)

unknown title
unknown artist
0:00

图论

我觉得还是有点必要向没接触过这方面的小朋友介绍一下 "图论" 是个什么东西的.

在这之前, 先来看一个经典的问题:

假设你居住的镇子有一条河完整的穿过, 并且河里有两座小岛, 两座小岛与河的两岸有七座桥相互连接, 那么是否有一种方法, 可以在不经过任意一座桥两次的同时, 完整经过所有的桥呢?

没错, 这就是大名鼎鼎的 "七桥问题", 全称 "柯尼斯堡七桥问题" (Seven Bridges of Königsberg).
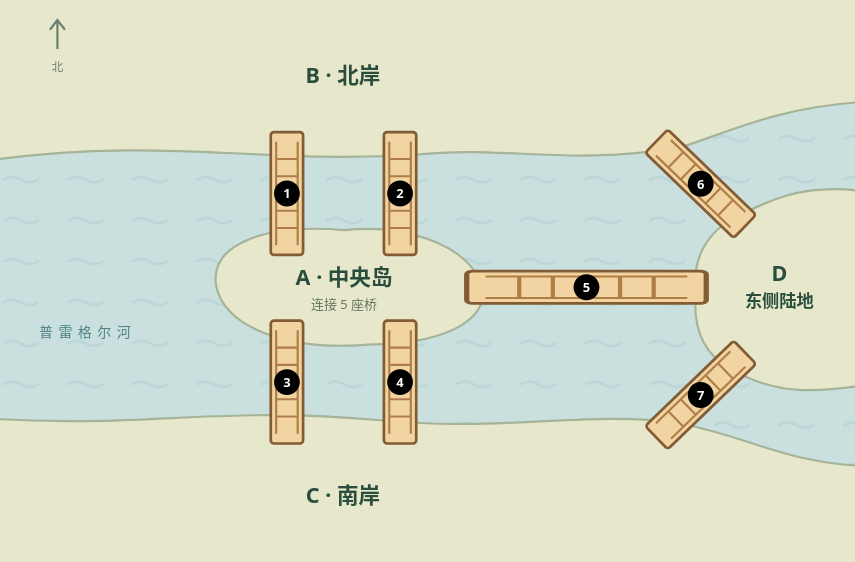
七桥问题 (GPT绘制)

如果你想要自己思考一下的话, 现在就可以先停下来思考一下了.

那么这个问题是如何解决的呢? 著名的数学家莱昂哈德·欧拉, 在几百年前就已经给出了解.

没错, 就是证明 "费马小定理" 提出 "欧拉函数" 的那个 "欧拉", 也是 "欧拉公式" 的那个 "欧拉"

欧拉函数 (欧拉筛求质数!):

aφ(n)≡1(modn)a^{\varphi(n)}\equiv 1 \pmod n

费马小定理 (往日种种...):

ap−1≡1(modp)a^{p-1}\equiv 1 \pmod p

欧拉公式 (世界上最美的公式之一):

eiπ+1=0e^{i\pi}+1=0

欧拉公式

上面的式子如果看不懂就忽略掉把, 只是因为突然想起来, 觉得很亲切

扯远了, 欧拉是如何解决这个问题的呢? 欧拉的思路也很简单, 在地图上想解决方法太不直观了, 作为一个数学家, 那么第一步就是把他抽象成一个数学问题; 图中所有的地面使用 "点" 来表示, 所有的桥使用 "边" 来表示, 那么上面的这个地图就可以表示成下面这样.
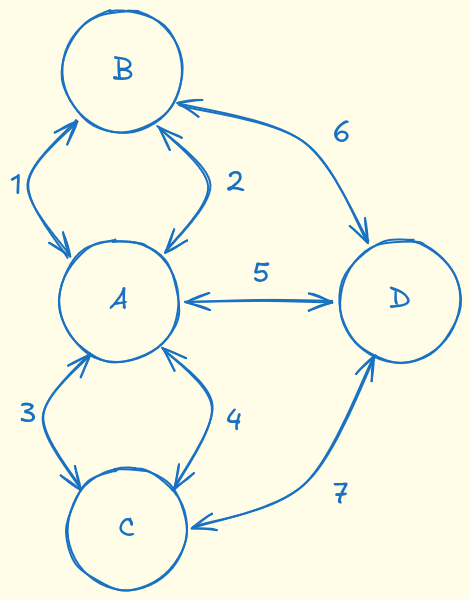
抽象成图

继续的, 按照 DP (Dynamic Programming, 动态规划) 的思想 (感觉这里写得有点不合理, 因为这个问题并不存在 DP 中的 "最优子结构"), 把整个图的全局问题忽略掉, 只看其中的一个最小单元是如何变化的.

对于其中的一个点, 只能有以下的三种走法:

  1. 以这个点为起点
  2. 以这个点为终点
  3. 经过这个点

如果用 "出入次数" 来对一个点进行讨论:

  • "起点" 和 "终点" 会为这个点的出入次数 +1, 如果经过这个点, 会为这个点的出入次数 +2
  • 同时, 有一个很重要的常识, "起点" 和 "终点" 在一次连续的路径中只会各存在一次
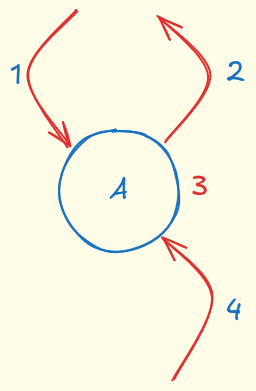
单个点的一种走法, 出入次数为3

那么这意味着什么? 综合上面的两条可以得到下面的结论:

当且仅当奇数点的数量是 0 或者 2 时, 可以一次完整走完所有的边.

反过来, 如果我们需要一次走完所有的边的话, 出入次数为奇数的点只能是 0 或者 2.

好, 现在可以回到地图了, 数数每片陆地要走完所有的桥需要几次出入?
我数出来是 A: 5, B: 3, C:3, D: 3.
显然, 他有四个奇数点, 是不可能一次性走完的.

综上, 这个问题被欧拉严密的被证明了他是无解的, 永远都不可能一口气走完所有的七座桥而不重复.

(这也顺带解决了一笔画问题 (Eulerian graph); 而能够一次性遍历所有的点, 而不重复经过某条边的图也被称为 "欧拉图". 遍历经过的路径也被称为 "欧拉路径"/"欧拉回路")

太伟大了!
有什么不懂的地方吗?

(其实七桥问题现在已经被物理意义上的解决了, 因为 2 和 4 位置对应的桥在二战的时候被炸掉了)

那么回到主题, 介绍这个有什么用呢? 因为这是世界上公认的 "第一个图论问题", 是图论整个分支的起源, 如果你已经能够自己动手解决这个问题了, 那么恭喜你, 你已经入门图论了.

(没错图论其实是数学的一个分支, 准确来说是 "组合数学" 的一个分支. 大三 (好像是) 的《离散数学》的教材上就有图论的内容)

拓扑排序算法

What?

首先, 拓扑排序不是排序算法, 是图论. (身败名裂 callback
苦酒入喉心作痛

为什么要有拓扑排序呢? 他解决了什么问题? 想象一下, 你有这样的一个插件系统, 其中插件 A 需要在插件 B 之后运行, 插件 C 需要在插件 B 之前运行, 那么你该如何编排插件的运行顺序?

那么这个时候就有小朋友要说了, "这还不简单? 不就是 C -> B -> A 嘛." 嗯, 确实如此, 但是如果需要找到一种特定的算法, 让任意合法的输入都能找到解呢? 很明显, "瞪眼法" 在这个时候就不起作用了.

Why?

那么拓扑排序是如何解决这个问题的呢?

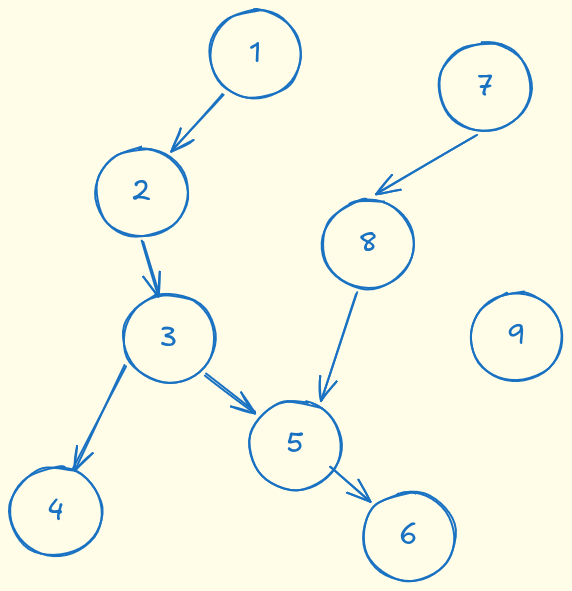
假设有这样的一个乱七八糟的依赖关系 (如下图), 其中圆圈代表点 (用 V 表示, vertex), 用箭头代表边 (用 E 表示, edge), 其中 EV1→V2E_{V_1 \rightarrow V_2} 表示 1 这个插件需要 2 作为前置条件.

依赖关系

一般来说解决这个问题主要有两种算法: 1. Kahn 风格的 BFS 算法; 2. Tarjan 风格的 DFS 算法.

没错, 这里说的 Tarjan 就是 Tarjan 求强连通分量的那个 Robert Tarjan, 图论宗师.
他的老师是 Robert W. Floyd, 代表算法是 Floyd 多源最短路算法, 算法的核心只有一行 (毕竟是DP):

dist[i][j]=min(dist[i][j],dist[i][k]+dist[k][j])dist[i][j]=min(dist[i][j], dist[i][k]+dist[k][j])

都是老熟人

扯远了, 那么我就以 Kahn 拓扑排序算法举栗, 他的核心思想就是 "删除顶点".

仔细想想, 既然我们需要被依赖的点排在前面, 那么这些点有什么特点呢? 通过 "瞪眼法", 我们需要排在前面的几个点分别是 44, 66, 99. 那么这些点有什么特点呢? 从图论的视角出发, 不难发现, 这些点都是不依赖其他点的, 也就是没有向外的箭头, 在图论中这些数值被称为 “出度”. (对应的, 向内的箭头数量就是 "入度")

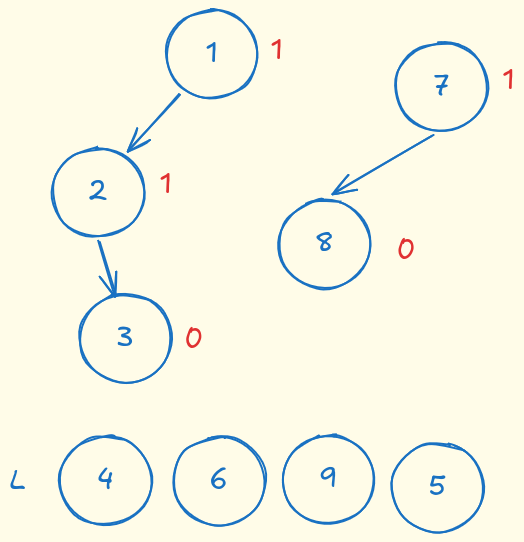
对于这些出度为 00 的点, 他们肯定是最先运行的一批, 可以直接拿出来作为结果的前面一部分, 也因为这个依赖项已经被解决了, 表示依赖关系的边也就兑现了, 可以直接删除.

设 LL 是最终结果, 那么经过这一步之后的图就变成了这样 (红色数字表示这个点的出度):
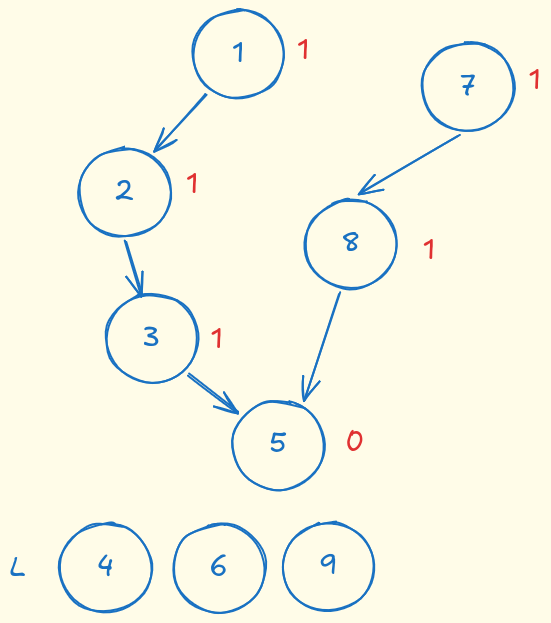
第一步

那么现在又有一个店 V5V_5 的出度变成了 00, 继续删掉这个点, 得到下图:

第二步

同理, 继续删除 33 和 88; 然后是 22 和 77; 最后删除 11. 整个图就全部清空了. 按照被删除的顺序我们就得到了他的一个拓扑排序的结果:

L=[V4,V6,V9,V5,V3,V8,V2,V7,V1]L=[V_4,V_6, V_9, V_5, V_3, V_8, V_2, V_7, V_1]

很明显, 这样的结果可以有很多个, 在出度全部都是 00 的那一次结果使用任意的顺序排列这些点都是可以的.

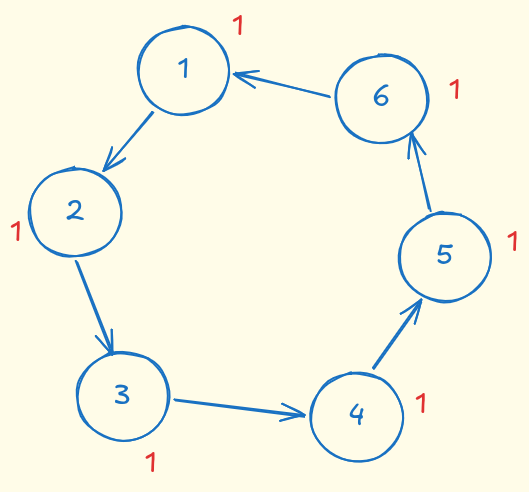
那么这个时候就要引出一个问题了, 如果图里进行到某一步之后, 压根就没有出度为 00 的点要怎么办呢? 类似于下面这样:

出度全为1

因为这个图根本就没有可以下手的地方, 所以他没有拓扑排序的结果.

另一种情况, 图论里的图按照边的类型, 可以分为两大类, 有明确指向的 "有向图" 和没有方向的 "无向图" (无向边表示哪个方向都可以走). 也正是因为两边都可以走, 所以两个点的度数都为 11. (无向图没有出度/入度的概念)

无向图也有一个著名的定理: 握手定理 (Handshaking Lemma).

在任意的无向图中, 顶点的度数之和为边数的两倍.
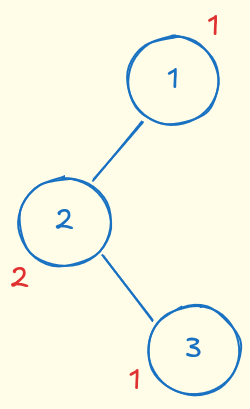
∑v∈Vd(v)=2∣E∣{\sum_{v \in V} d(v) = 2|E|}

无向图的度数

因为无向图的点只有在没有边的时候度数才是 00, 但是这个情况下拓扑排序也就没有意义了. 所以无向图也是没有拓扑排序的结果的. (拓扑排序本来就是求解依赖图的, 无向图根本没有依赖关系, 当然没有解了)

上面的两个反例可以总结起来, 称为有向无环图 (Directed Acyclic Graph, DAG), 也就是说拓扑排序只在有向无环图下有结果.

好, 看到这里. 有没有发现一个奇怪的地方? 可能你之前在某些地方看到 Kahn 拓扑排序算法的明明是计算 "入度" 的, 但是为什么在我这里是出度呢?

这是因为我们建边的方式不一样, 我习惯从 "生产者" 指向 "消费者", 也就是 "提出这个请求的点" 指向 "被请求的点", 你只需要把边的方向反过来, 他就从 “出度” 变成 "入度" 了, 也就是常见的那样. (总之绝对不是不小心随手写的, 结果快写完了才发现有问题)
笨蛋

How?

知道了这些, 我们就可以简单的用代码来实现他了.

首先, 我们要如何表示一个图呢? 一般来说有两种主流的方式, 一个是使用数组实现的邻接矩阵, 一个是使用链表实现的邻接表. 但是他们都不太直观, 我就用面向对象的方法来演示吧.

第一步, 如何表示一个顶点呢? 因为我们希望所有的边都是独立的, 所以使用不同的对象就可以直接表示他了:

class V:
    pass


v1 = V()
v2 = V()
# v1, v2 都是各自实例化得到的不同对象
print(v1, v2)  # True

有了顶点, 边要如何表示呢? 因为边需要有一个起点和一个终点, 我们也可以用携带 start 和 end 两个信息的对象来表示他:

class V:
    pass


class E:
    def __init__(self, start, end):
        self.start = start
        self.end = end


v1 = V()
v2 = V()
e_12 = E(v1, v2)

# 题外话
# 那么要如何判断两条边是否是同一条呢?
# 很明显的, 只要起点和终点是一样的就可以认为是同一条边

# 为 E 添加一个 `__eq__` 魔术方法, 这个方法控制他如何处理 `==`
def E__eq__(self, other):
    if self.start == other.start and self.end == other.end:
        # 如果这条边的起点与终点与另一条边分别相等, 那么就认为他是同一条边
        return True
    return False
E.__eq__ = E__eq__

e_12_other = E(v1, v2)
print(e_12 == e_12_other)  # True

# 因为是有向边, 需要区分起点和终点
e_21 = E(v2, v1)
print(e_12 == e_21)  # False

再想想, 我们还需要什么? 对了, 还需要圆圈边上的红色数字, 度数, 如果记不得要用出度还是入度的话, 最好的办法就是 "我全都要!". 因为这是顶点的属性, 在 V 里面加上就行, 如果我们对某个顶点建边的话, 那么就需要更新度数, 代码如下:

class V:
    def __init__(self):
        # 初始化出度入度为 0
        self.indegree = 0
        self.outdegree = 0
		# 记录这个顶点关联的边, 方便后续删除
        self.in_edges = []
        self.out_edges = []


class E:
    def __init__(self, start, end):
        self.start = start
        self.end = end

        # 建立了一条边之后再分别给这两个点添加出入度
        # 起点的箭头向外, 加的是出度
        self.start.outdegree += 1
        # 终点的箭头向内, 加的是入度
        self.end.indegree += 1

        # 记录关联的边
        self.start.out_edges.append(self)
        self.end.in_edges.append(self)

	# 定义要如何从图上删除这个边
    def delete(self):
        self.start.outdegree -= 1
        self.end.indegree -= 1
        self.start.out_edges.remove(self)
        self.end.in_edges.remove(self)


v1 = V()
v2 = V()
print(f"v1: 入度为{v1.indegree}, 出度为{v1.outdegree}")  # 0, 0
print(f"v2: 入度为{v2.indegree}, 出度为{v2.outdegree}")  # 0, 0

e_12 = E(v1, v2)
print("---添加一条边---")

print(f"v1: 入度为{v1.indegree}, 出度为{v1.outdegree}")  # 0, 1
print(f"v2: 入度为{v2.indegree}, 出度为{v2.outdegree}")  # 1, 0

很好, 那么用了这 20 多行代码之后就基本上可以表示一个附带度数的有向无环图了, 试着建一下最开始的那个图:

class V:
    def __init__(self):
        self.indegree = 0
        self.outdegree = 0
        self.in_edges = []
        self.out_edges = []


class E:
    def __init__(self, start, end):
        self.start = start
        self.end = end
        self.start.outdegree += 1
        self.end.indegree += 1
        self.start.out_edges.append(self)
        self.end.in_edges.append(self)

    def delete(self):
        self.start.outdegree -= 1
        self.end.indegree -= 1
        self.start.out_edges.remove(self)
        self.end.in_edges.remove(self)


# 顶点
v1 = V()
v2 = V()
v3 = V()
v4 = V()
v5 = V()
v6 = V()
v7 = V()
v8 = V()
v9 = V()

# 边
e_12 = E(v1, v2)
e_23 = E(v2, v3)
e_34 = E(v3, v4)
e_35 = E(v3, v5)
e_56 = E(v5, v6)
e_78 = E(v7, v8)
e_85 = E(v8, v5)
# v9 没有边

print(f"v1: 入度为{v1.indegree}, 出度为{v1.outdegree}")  # @!%C&*...
print(f"v2: 入度为{v2.indegree}, 出度为{v2.outdegree}")
print(f"v3: 入度为{v3.indegree}, 出度为{v3.outdegree}")
print(f"v4: 入度为{v4.indegree}, 出度为{v4.outdegree}")
print(f"v5: 入度为{v5.indegree}, 出度为{v5.outdegree}")
print(f"v6: 入度为{v6.indegree}, 出度为{v6.outdegree}")
print(f"v7: 入度为{v7.indegree}, 出度为{v7.outdegree}")
print(f"v8: 入度为{v8.indegree}, 出度为{v8.outdegree}")
print(f"v9: 入度为{v9.indegree}, 出度为{v9.outdegree}")

好了, 现在图有了, 就可以正式开始写拓扑排序的算法了, 首先回顾一下刚刚说到的第一步是什么? 没错, 先收集所有的出度为 00 的顶点. (不是入度是因为我的图是反的)

class V:
    _counter = 0

    def __init__(self):
        self.indegree = 0
        self.outdegree = 0
        self.in_edges = []
        self.out_edges = []

        # 加上这个用于在print函数里显示名字
        V._counter += 1
        self.name = f"v{V._counter}"

    # 加上这个用于在print函数里显示名字
    def __repr__(self):
        return self.name


class E:
    def __init__(self, start, end):
        self.start = start
        self.end = end
        self.start.outdegree += 1
        self.end.indegree += 1
        self.start.out_edges.append(self)
        self.end.in_edges.append(self)

    def delete(self):
        self.start.outdegree -= 1
        self.end.indegree -= 1
        self.start.out_edges.remove(self)
        self.end.in_edges.remove(self)


v1 = V()
v2 = V()
v3 = V()
v4 = V()
v5 = V()
v6 = V()
v7 = V()
v8 = V()
v9 = V()

e_12 = E(v1, v2)
e_23 = E(v2, v3)
e_34 = E(v3, v4)
e_35 = E(v3, v5)
e_56 = E(v5, v6)
e_78 = E(v7, v8)
e_85 = E(v8, v5)


# 算法入口
def toposort():
    # 拓扑排序算法
    # 还在图里的顶点
    g = [v1, v2, v3, v4, v5, v6, v7, v8, v9]
    # 拓扑排序的结果
    l = []

    def collect_zero_outdegree():
        # 出度为0的点
        zero = []

        # 收集所有的出度为0的点
        for v in list(g):
            if v.outdegree == 0:
                zero.append(v)

        # 把出度为 0 的顶点删除, 并放进结果里
        for v in zero:
            g.remove(v)
            l.append(v)
            # 删除对应的边
            for e in list(v.in_edges):
                e.delete()


    collect_zero_outdegree()

    # 看看第一次收集的结果
    print(l)  # [v4, v6, v9]
    print(f"v1: 入度为{v1.indegree}, 出度为{v1.outdegree}")
    print(f"v2: 入度为{v2.indegree}, 出度为{v2.outdegree}")
    print(f"v3: 入度为{v3.indegree}, 出度为{v3.outdegree}")
    print(f"v4: 入度为{v4.indegree}, 出度为{v4.outdegree}")
    print(f"v5: 入度为{v5.indegree}, 出度为{v5.outdegree}")
    print(f"v6: 入度为{v6.indegree}, 出度为{v6.outdegree}")
    print(f"v7: 入度为{v7.indegree}, 出度为{v7.outdegree}")
    print(f"v8: 入度为{v8.indegree}, 出度为{v8.outdegree}")
    print(f"v9: 入度为{v9.indegree}, 出度为{v9.outdegree}")


# 运行
toposort()

因为删点的时候会顺带把边也一起删掉, 所以收集完一轮之后又有新的点的出度变成 00, 那么就可以继续收集这些点:

class V:
    _counter = 0

    def __init__(self):
        self.indegree = 0
        self.outdegree = 0
        self.in_edges = []
        self.out_edges = []

        V._counter += 1
        self.name = f"v{V._counter}"

    def __repr__(self):
        return self.name


class E:
    def __init__(self, start, end):
        self.start = start
        self.end = end
        self.start.outdegree += 1
        self.end.indegree += 1
        self.start.out_edges.append(self)
        self.end.in_edges.append(self)

    def delete(self):
        self.start.outdegree -= 1
        self.end.indegree -= 1
        self.start.out_edges.remove(self)
        self.end.in_edges.remove(self)


v1 = V()
v2 = V()
v3 = V()
v4 = V()
v5 = V()
v6 = V()
v7 = V()
v8 = V()
v9 = V()

e_12 = E(v1, v2)
e_23 = E(v2, v3)
e_34 = E(v3, v4)
e_35 = E(v3, v5)
e_56 = E(v5, v6)
e_78 = E(v7, v8)
e_85 = E(v8, v5)


def toposort():
    g = [v1, v2, v3, v4, v5, v6, v7, v8, v9]
    l = []

    def collect_zero_outdegree():
        zero = []
        for v in list(g):
            if v.outdegree == 0:
                zero.append(v)
        for v in zero:
            g.remove(v)
            l.append(v)
            for e in list(v.in_edges):
                e.delete()

    collect_zero_outdegree()
    collect_zero_outdegree()

    # 看看第二次收集的结果
    print(l)  # [v4, v6, v9, v5]
    print(f"v1: 入度为{v1.indegree}, 出度为{v1.outdegree}")
    print(f"v2: 入度为{v2.indegree}, 出度为{v2.outdegree}")
    print(f"v3: 入度为{v3.indegree}, 出度为{v3.outdegree}")
    print(f"v4: 入度为{v4.indegree}, 出度为{v4.outdegree}")
    print(f"v5: 入度为{v5.indegree}, 出度为{v5.outdegree}")
    print(f"v6: 入度为{v6.indegree}, 出度为{v6.outdegree}")
    print(f"v7: 入度为{v7.indegree}, 出度为{v7.outdegree}")
    print(f"v8: 入度为{v8.indegree}, 出度为{v8.outdegree}")
    print(f"v9: 入度为{v9.indegree}, 出度为{v9.outdegree}")


toposort()

也正因如此, 可以直接写个循环一直判断 g 是否为空就可以收集到所有的结果了. (前提是你的图确实的有向无环图, 不然会死循环)
最终代码:

class V:
    _counter = 0

    def __init__(self):
        self.indegree = 0
        self.outdegree = 0
        self.in_edges = []
        self.out_edges = []

        V._counter += 1
        self.name = f"v{self._counter}"

    def __repr__(self):
        return self.name


class E:
    def __init__(self, start, end):
        self.start = start
        self.end = end
        self.start.outdegree += 1
        self.end.indegree += 1
        self.start.out_edges.append(self)
        self.end.in_edges.append(self)

    def delete(self):
        self.start.outdegree -= 1
        self.end.indegree -= 1
        self.start.out_edges.remove(self)
        self.end.in_edges.remove(self)


v1 = V()
v2 = V()
v3 = V()
v4 = V()
v5 = V()
v6 = V()
v7 = V()
v8 = V()
v9 = V()

e_12 = E(v1, v2)
e_23 = E(v2, v3)
e_34 = E(v3, v4)
e_35 = E(v3, v5)
e_56 = E(v5, v6)
e_78 = E(v7, v8)
e_85 = E(v8, v5)


def toposort():
    g = [v1, v2, v3, v4, v5, v6, v7, v8, v9]
    l = []

    def collect_zero_outdegree():
        zero = []
        for v in list(g):
            if v.outdegree == 0:
                zero.append(v)
        for v in zero:
            g.remove(v)
            l.append(v)
            for e in list(v.in_edges):
                e.delete()

    while g:
        collect_zero_outdegree()

    print(l)  # [v4, v6, v9, v5, v3, v8, v2, v7, v1]


toposort()

这个时候你应该就发现了, 拓扑排序其实相当简单, 主要代码只有 collect_zero_outdegree 函数里的那几行, 在 CLRS (《算法导论》) 里更是只有三行伪代码. (虽说他使用的是 DFS, 而我用的是 BFS)
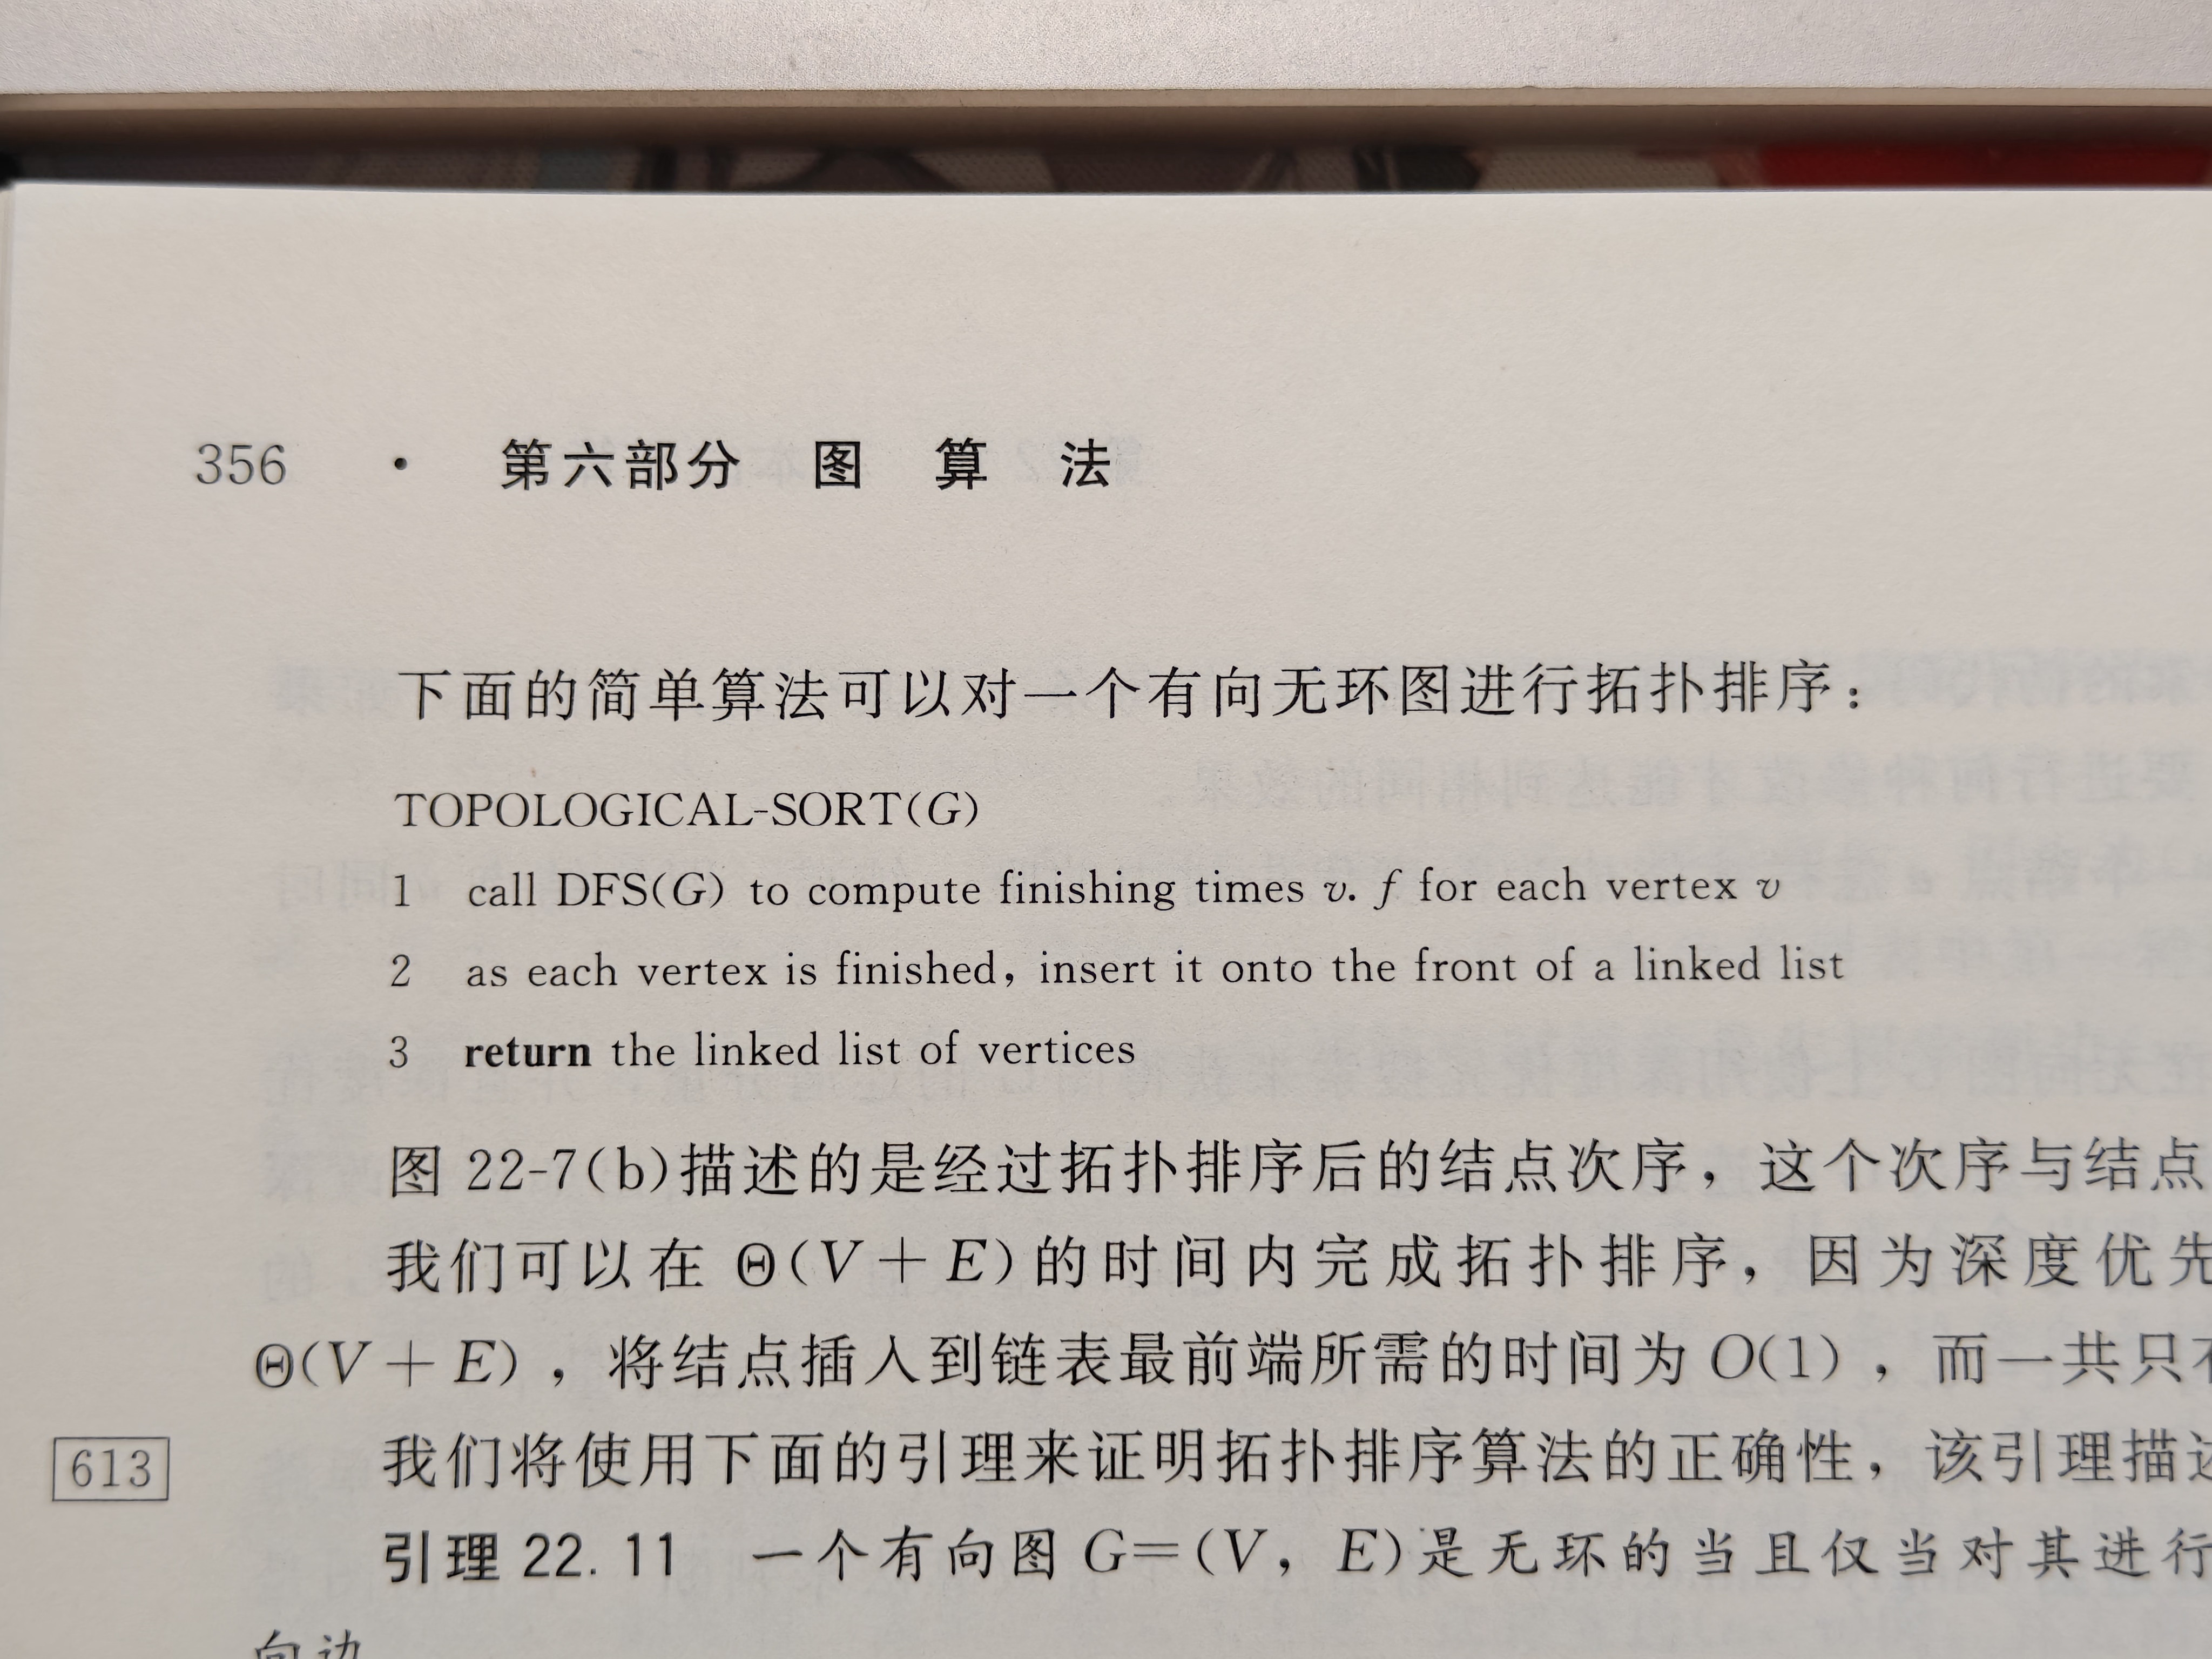
CLRS 里的拓扑排序伪代码

(讲真, 我觉得伪代码相当难读, 而且每个地方的写法都不一样, 还不如贴一段真正的代码来得实在. 不过可能也是因为工程思维作祟吧, 说不定对于他们搞理论的来说这就是最好的方式呢?)

还有就是这本书太难了, 如果不是很有自信的话就不推荐了

Review?

既然代码有了, 那么再来分析一下他的时间复杂度吧, 就用标准的大 OO 表示法. (有时候也写作花体 O\mathcal{O} )

首先, 找一下代码的核心循环, 是 while 的这一段, 把 collect_zero_outdegree 函数展开到循环内部, 可以写成下面这样:

while g:  # 1
    zero = []
    for v in list(g):  # 2
        if v.outdegree == 0:
            zero.append(v)
    for v in zero:
        g.remove(v)  # 3
        l.append(v)
        for e in list(v.in_edges):  # 4
            e.delete()  # 5
  1. 在最坏的情况下, 每次只会删除一个点, 所以这里最多执行 VV 次. (VV 是图中的顶点数量)
  2. 在这里 list(g) 会完整复制一次数组 g, 复杂度是 O(∣g∣)O(|g|), 最坏也是一次删除一个点, 又因为在 1 的内部进行循环, 所以 ∣g∣|g| 依次为 V,V−1,...,1V, V-1, ..., 1, 合起来就是下边这样: (大 OO 表示法省略常数项)
    ∑k=1Vk=(V+1)⋅V2=O(V2)\sum^V_{k=1}k=\frac{(V+1)\cdot V}{2}=O(V^2)
  3. Python 里的 list.remove 方法是从头到尾进行遍历查找的, 最坏的情况每次都删除最后一个值, 复杂度是 O(∣g∣)O(|g|), 因为 1 的循环存在, 也需要乘以 VV, 复杂度和 2 一样是 O(V2)O(V^2)
  4. 这里的 list(v.in_edges) 也会完整被复制一次, 但是因为每条边最多只会遍历一次 (因为被删除了), 所以成本是固定的 O(E)O(E). (EE 是边的数量)
  5. 我将用最直白, 最不绕弯子的方法告诉你, 这里我算不来. 大肥鱼算出来是 O(V⋅E)O(V\cdot E).

把他们全部加起来:

V2+V2+E+VEV^2 + V^2 + E + VE

合并:

2V2+(E+1)V2V^2+(E+1)V

省略常数项, 得到最终的复杂度:

O(V2+EV)\boxed{O(V^2+EV)}

那么标准的 Kahn 算法是怎样的呢? 他是 O(V+E)O(V+E) 的, 也就是常说的线性 O(N)O(N), 而我上面的这个实现是平方级的 O(N2)O(N^2). 他们的增长速度如图:

很明显, 在正式场合写出这样的复杂度是要被拖出去打死的
突然想到一个O(n^{n!}!)的算法

那么如何对上面的这份代码进行优化呢? 虽然最外层的 while 循环是不可避免的, 但是内部的 O(N)O(N) 级的操作似乎有下手的空间?

回头看看贡献了复杂度的那四个部分, 主要的问题是列表的完整操作 (复制和删除) 和删除顶点的边 (其实这也是列表操作, 只是性质不太一样)

仔细想想, 第一个问题可以优化吗? 原来的问题在于每次操作都需要遍历一遍 g, 这个是可以省略的吗? 其实是可以的, 我们在删边的时候不是正好修改了其他顶点的度数吗? 既然如此, 就把他也加入到结果中, 然后继续删边, 这样就省下了一次 O(V)O(V) 的遍历.

同时删除边的时候的 list.remove() 方法也是 O(N)O(N) 的, 但是后面就用不到这个 V.out_edges 属性了, 所以干脆偷懒, 不真正删掉这个东西, 只是减少 V.outdegree 的数值就够了, 这样又省掉了一个 O(E)O(E) 的遍历. 同时, 因为我们并不需要删边了 list(v.in_edges) 的复制操作也可以省略了. (这个复制操作在原来的实现中是必须的, 边修改边遍历列表可能会造成各种奇怪的问题)

最终代码:

class V:
    _counter = 0

    def __init__(self):
        self.indegree = 0
        self.outdegree = 0
        self.in_edges = []
        self.out_edges = []

        V._counter += 1
        self.name = f"v{self._counter}"

    def __repr__(self):
        return self.name


class E:
    def __init__(self, start, end):
        self.start = start
        self.end = end
        self.start.outdegree += 1
        self.end.indegree += 1
        self.start.out_edges.append(self)
        self.end.in_edges.append(self)


v1 = V()
v2 = V()
v3 = V()
v4 = V()
v5 = V()
v6 = V()
v7 = V()
v8 = V()
v9 = V()

e_12 = E(v1, v2)
e_23 = E(v2, v3)
e_34 = E(v3, v4)
e_35 = E(v3, v5)
e_56 = E(v5, v6)
e_78 = E(v7, v8)
e_85 = E(v8, v5)


def toposort():
    g = [v1, v2, v3, v4, v5, v6, v7, v8, v9]
    l = []
    # 使用列表推导式预先收集所有的出度为 0 的点
    # 等价于下面的写法, 但是列表推导式会更快更简洁
    # ```python
    # stack = []
    # fpr v in g:
    #     if v.out_edgrs == 0:
    #         stack.append(v)
    # ```
    stack = [v for v in g if v.outdegree == 0]

    while stack:
        # 取出栈顶的顶点
        v = stack[-1]
        stack.pop()
        # 登记结果
        l.append(v)

        # 继续删边, 每条边最多遍历一次, 复杂度总计 O(E)
        for e in v.in_edges:
            e.start.outdegree -= 1  # 只减少出度
            # e.end.indegree -= 1   # 这个没用到也可以省略
            if e.start.outdegree == 0:
                stack.append(e.start)

    print(l)  # [v9, v6, v5, v8, v7, v4, v3, v2, v1]


toposort()

因为对于栈 stack 而言, 最多也只会出入所有的顶点一次, 所以复杂度是固定的 O(V)O(V), 而 for e in v.in_edges: 循环本质是删边, 每条边又最多被删除一次所以他的复杂度也是固定的 O(E)O(E). 因为 while 循环里的两段代码都是固定的复杂度, while 的复杂度倍数也就失去意义了, 这个新的算法的复杂度是恒定的 O(V+E)O(V+E).

其实呢, 原先的朴素 BFS 拓扑排序算法优化到这里, 已经是一个 kahn 算法了 (准确来说是他的一个面向对象变体)

感兴趣的话可以去看看 A. B. kahn 发布在 ACM 上的原文: Topological sorting of large networks (看不懂)

当然, 一般都不会这么写, 面向对象太浪费内存性能了, 一般会用预分配的邻接矩阵和邻接表, 栗子: (当然, 不用 Python 干这种活性能会更好)

n = 10
edges = [
    (1, 2),
    (2, 3),
    (3, 4),
    (3, 5),
    (5, 6),
    (7, 8),
    (8, 5),
]

# 邻接表:g[v] 表示所有指向 v 的点
g = [[] for _ in range(n)]
outdegree = [0] * n
for u, v in edges:
    g[v].append(u)
    outdegree[u] += 1


def toposort():
    out = list(outdegree)
    stack = [i for i in range(1, n) if out[i] == 0]

    order = []
    while stack:
        u = stack.pop()
        order.append(u)

        for v in g[u]:  # 遍历指向 v 的点
            out[v] -= 1
            if out[v] == 0:
                stack.append(v)
    return order


print(toposort())  # [9, 6, 5, 8, 7, 4, 3, 2, 1]

Proof?

你凭什么说你的算法是正确的呢? 你有证据吗?

Kahn 算法的正确性可以用数学归纳法来证明, 不过可能要用到很多术语, 看不懂就掠过吧. (反正对写代码也没什么帮助)

设, 一个有向图 G=(V,E)G=(V,E), 其中 VV 是所有顶点的集合, EE 是所有边的集合.

已知:

  • 引理1, 对于任意的 DAG, 至少存在一个入度为 00 的点
  • 引理2, DAG 删除一个入度为 00 的点后仍为 DAG

Kahn 算法的正确性证明:

  1. 对于 DAG 的任意一条边 u→vu \rightarrow v, 在这条边被删除之前, vv 的入度至少为 1, 因为 u→vu \rightarrow v 存在. 因此 vv 不可能入度为 00, vv 也就不可能先于 uu, 所以 "uu 在 vv 之前" 一定成立. 由于这对 GG 中任意边都成立, 所以输出的是拓扑序.
  2. 由引理1, GG 的初始状态中至少有一个入度为 00 的点, 所以算法第一步可以进行. 删除第一个顶点之后, 由引理 2, 剩余图依旧是 DAG. 如果剩余顶点存在, 那么剩余图非空, 由引理 1, 它依旧有入度为 00 的点, 于是算法又可以继续. 如此反复, 只要还有顶点, 就一定能够找到入度为 00 的点, 并将其输出. 因此算法会得到所有的 nn 个顶点. 于是算法得到的序列, 既是拓扑序, 又包含所有顶点.

虽然知道不太合适, 但是还是想放这张图(

Realworld?

写不下去了, 就这样吧. 本来应该还有一章的.

代码 在这, 如果没兴趣的话就直接忽略吧. 主要的变化是引入了一个小根堆和优先级约束来保证他的顺序, 但是性能也退化到了 O(E+VlogV)O(E+VlogV).


习题: leetcode 210

(刚开始写这道题的时候, 我建的边又反了)

我的代码
class Solution:
    def findOrder(self, numCourses: int, prerequisites: list[list[int]]) -> list[int]:
        n = numCourses

        g = [[] * n for _ in range(n)]
        indegree = [0] * n
        for req in prerequisites:
            a, b = req
            g[b].append(a)
            indegree[a] += 1

        stack = [i for i, v in enumerate(indegree) if v == 0]
        result = []
        while stack:
            u = stack.pop()
            result.append(u)

            for v in g[u]:
                indegree[v] -= 1
                if indegree[v] == 0:
                    stack.append(v)

        if len(result) == n:
            return result
        return []

扩展思考 (难度较高, 我也不会): 给出一个 DAG, 任取图中两点, 如何在线性时间内计算这两点的简单路径数量?


有问题别问我啊, 我也不懂, 我也就一个没上过几节正经课的计算机 "民科". 那本 CSAPP 至今都没看完.
(喝)


正确的!