从零开始的 S3 之旅
省流: 别写, 是史山
看到标题就应该知道这次要写什么了吧, 没错, 大名鼎鼎的 Amazon S3 API.
为什么说大名鼎鼎呢? 因为 S3 API 凭借先发优势现在已经成为了对象存储的事实标准了. (发布于 2006 年, 是历史上第一个大规模商业化的对象存储服务, 虽说我连亚马逊云的账号都没有) 包括我现在使用的 CF (Cloudflare) 的对象存储服务 R2, 他也是明确推荐使用 S3 兼容的 API, 而不是自己的 Cloudflare RESTful API.
不过嘛, AWS (亚马逊云) 的 SDK, 用过的都懂, 难用的同时还臃肿, 恨不得把自己家里所有的服务全部都塞给你, 好充分压榨你的钱包. 类型提示差就算了, 并且每次打开带有 boto3 依赖的代码的时候, 都会导致我的 IDE卡一下. 这其实还算是好的了, 某些一线大厂的云服务 SDK 甚至有 100MB, 导致某些开发者直接在 issue 里破口大骂
S3 API 的结构
S3 API 的结构其实相当简单, 把 S3 endpoint 和 key 拼起来就是一个完整的 S3 URL 了. 如下图:
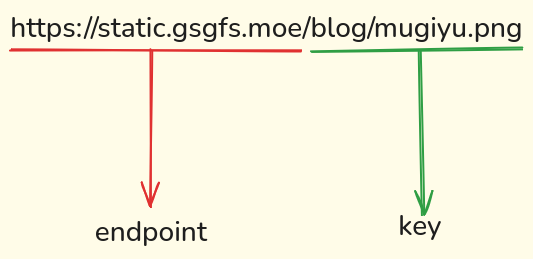
(需要注意的是, 我的这个域名已经绑定了 bucket 了, 所以可以直接省略中间的 bucket, 如果没有绑定的话就需要显示传递 bucket, 类似下面这样)
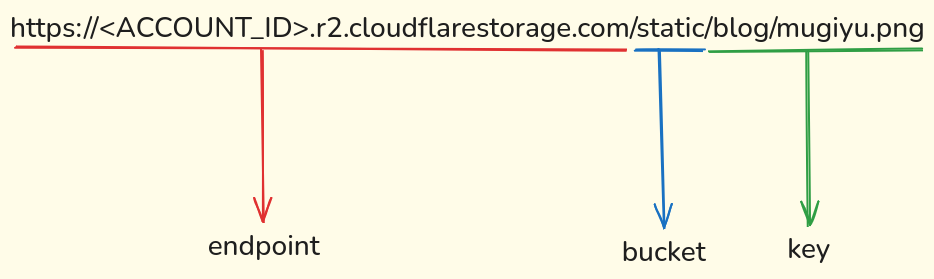
S3 API 通过 HTTP 的语义化的请求方法来实现对应的操作, 比如说对着这个 URL 发送一个 HTTP GET 请求, S3 就会把文件的内容发给你, 发送一个 HTTP DELETE 请求就会删掉这个文件. (因为浏览器打开 HTTP URL 的默认请求就是 GET, 所以你也可以直接在浏览器里输入这个 URL 来打开这个图片)
简单 GET
知道了这些, 我们就可以写出下面的代码:
=
return
=
其中, httpx2 是 httpx 库的一个活跃 fork. (后者已经快两年没有发布新的版本了)
运行代码, 如果没有问题的话结果如下, (icat 是 kitty 终端特有一个命令, 用于在终端里显示图片, 你也可以用其他的看图软件替代, 还有别忘了装 httpx2 这个依赖库):
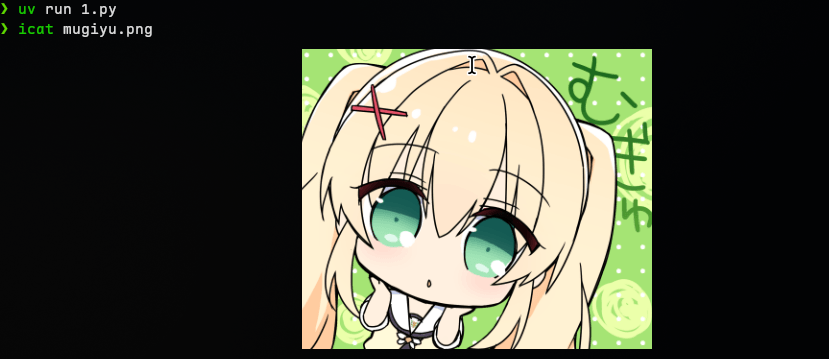
那么, 为什么 blog/mugiyu.png 这个路径会被叫成 key 呢? 因为对象存储用的一般都是扁平的文件结构, 所有的文件都平铺在 "根文件夹" 下, / 这样的 Unix 风格换行符在他的眼里其实也是 "文件名" 的一部分. (就像是 Unix 系统不认识表示文件后缀名的那个点一样) 感兴趣的话可以看看 CF 对于 R2 的描述: How R2 works
相应的, 对于上传一个文件, 对应的方法是 PUT, 也可以很快得到这样一段代码:
=
=
但是呢, 这段代码其实运行不了, 知道的朋友应该都知道了, 因为对于这种不安全的操作需要认证. 这段代码会直接返回一个 httpx2.HTTPStatusError 异常, 提示你没有权限进行操作.
AWS Signature V4 认证
第三方库
S3 的 API 使用的认证方式是在 Authorization 请求头中添加 AWS 自创的 AWS Signature V4 认证. (简称 Sig V4)
那么如何使用这个认证呢, 如果你不想手写的话, 可以使用类似于 httpx-aws-auth 这样的提供 Sig V4 签名的包.
=
=
=
=
=
=
(上面的代码使用了 garage, 这个自建 S3 服务作为演示. 他使用的就是标准的 S3 path-style, URL 是 endpoint + bucket + key)
但是他又引入了我们不想要的 httpx 依赖, 所以最干净的方法就是自己手写一个. 手搓仙人 (非褒义)
手搓
AWS 有一份很完整的文档, 描述了要如何手搓一个: Create a signed AWS API request
整个流程大致分为 5 个步骤, 跟文档里的一样
-
创建规范请求 (canonical_request)
规范请求使用 6 部分拼接<HTTPMethod>\n -> "GET", "PUT", "DELETE"... <CanonicalURI>\n -> "/blog/mugiyu.png" <CanonicalQueryString>\n -> "a=1&b=2" (需要排序) <CanonicalHeaders>\n -> "host:localhost:3900\nx-amz-content-sha256:xxx\nx-amz-date:20260806T131305Z\n" (需要排序) <SignedHeaders>\n -> "host;x-amz-content-sha256;x-amz-date" <HashedPayload> -> "e3b0...b855" (请求体的哈希值) -
哈希这个规范请求 (hashed_canonical_request)
-
创建待签名字符串 (string_to_sign)
他也是由 4 部分组成AWS4-HMAC-SHA256\n <RequestDateTime>\n -> "20260806T131305Z" (ISO 8601) <CredentialScope>\n -> "20260806/garage/s3/aws4_request" <SHA256(CanonicalRequest)> -> (第二步的 hashed_canonical_request) -
派生签名密钥 (signing_key)
这个也很麻烦, 需要拿 SECRET_KEY 依次对 时间, 区域, 服务, "aws4_request" 先后哈希四次 (其实就是 scope 的四个组成部分) -
创建最终签名 (signature)
用上一步的 signing_key 对 第三步的 string_to_sign 签名.
最后的完整代码类似于这样:
# 这里要改成你自己的
=
=
=
=
=
=
=
=
# 1. canonical request
=
= .
= +
=
=
=
=
# 2. hashed canonical request
=
# 3. string to sign
# scope: "<YYYYMMDD>/<region>/<service>/aws4_request"
# e.g.: "20260806/garage/s3/aws4_request"
= f
=
# 4. signing key
return
=
=
=
=
# 5. signature
=
=
=
return
=
=
return
试着运行一下:
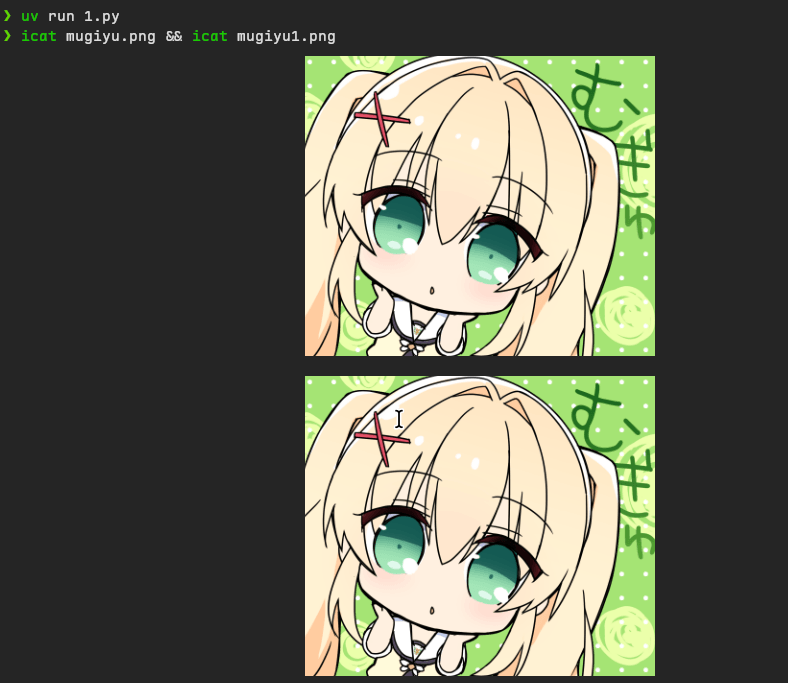
复杂吗? 我也觉得, 之前写的时候就到处写错, 到现在重写一遍也还是要靠 AI. 严重怀疑 AWS 是不是不想让我们用这个, 整个逻辑从头到尾都透露着过度设计的味道, 虽说我从头到尾都挑不出毛病来.
说到过度设计, 我自己好像也经常这么做, 写接口的时候想到哪写到哪, 结果写出来的东西自己都接不上.
同样的, 按照这个逻辑就可以实现剩下的 DELETE, HEAD 这些了, 我就不演示了, 我的实现可以参考 这里. (1600多行很长吗? 我觉得还好啊)
综上所述, 不推荐写, 我的代码里几乎全都是异常情况处理和规范化相关的代码 (史山). 让代码跑起来虽然简单, 但是想让他好用的话就要付出点代价了. 如果真的有需要的话, 可以去看看其他的 S3 客户端, 比如说用 Rust 写的 obstore
CRC?
原本这里还有一个章节的, 用来校验文件是否在传输的过程中发生损坏, 但是他太难了, 感觉可以单独开一篇文章来写了, 所以这部分随缘吧.
主要是这部分大部分都是 AI 的代码, 并且写到后面乱七八糟的符号太多了, 就完全看不懂他在干什么了, 属于是 AI 敢写我都不敢抄了. 虽说最后还是抄了, 要怪就怪 AI 的代码跑得太快了, 我也不想的. 😭
这个时候就要引用名人名言了 (还好我的这些代码没有 reviewer):
最近发现, 自己写代码的水平越来越差了, 之前写代码看到一个 拓扑排序, 我还真的认真想了下这是什么 排序算法, 直后面看到 AI 说入度出度才想起来, 这压根就不是排序算法, 这个一个 图论, 还是图论的基础入门算法.
已经完全无法想象没有 AI 要如何写代码了, 这就是所谓的 "工具越强大, 人类越退化" 吗?
怎么感觉这期这么短? 总之, 首先排除选题太难, 导致新文章难产