写点新玩意
背景
熟悉我的都知道, 我没写过什么拿的出手的东西, 迄今为止写过最大的项目还是我的博客网站, 就是你现在正在看的这个.
实话说, 我个人其实不怎么喜欢写大型的项目, 主要的原因还是太麻烦了. 因为我写代码全凭兴趣, 兴趣到那我就学到哪, 代码也跟着写到哪, 如果要我写一个正儿八经的项目的话有很大的一部分可能性会写到一半就放弃了. emm... 简单来说, 我只想写我想写的代码, 对于那些业务代码不是很感兴趣, 在代码里夹杂私货才是最棒的!
但是呢, 这有个什么问题呢, 没个正经项目不好找工作, 经常是简历投出去就挂了. 所以, 我这次想要写点新的东西, 可以拿的出手的东西.
How
有时候有选择反而比没有选择更加可怕, 这么多可以写的东西, 我到底要写些什么呢, 选择困难症又犯了.
我去问了问 AI, AI 告诉我一些可能会有用的方向:
- 体现出自身技能的深度和广度
- 展示优秀的工程能力
- 突出个人的亮点
应该就是这几点, 太久了, 我也忘的差不多了.
那么大致的需求有了, 具体要写什么呢.
之前闲的没事去维护一下已经很久没有上线过的 VPS, 发现了我使用的一个 VPS 监控服务有更新, 对于 Arch 用户, 肯定是需要无脑使用最新版的. 但是, 我没有注意看, 那个新的版本是与旧版本数据不兼容的, 在更新之后所有数据都丢失了.
这意味着我又要重新配置一遍所有的配置? 这一点我自然是不愿意的, 使用 Arch 的大概可以分为两类, 一类是真心喜欢折腾的, 另一类只是比较懒, 被 AUR 腐乳了. 显然, 我属于后者. 所以我决定放弃这个服务, 自己从头写一个.
写个监控面板
既然确定了要写什么剩下的自然就水到渠成了, 不要小看了我和 AI 的羁绊啊, 铁咩!
在架构设计的方面, 既然要突出自己的优势, 那必须得写个多语言融合的项目了
首先, 这个项目大概分为三个部分,
- agent: 用于收集和上报数据, 我选择使用 Python 来实现, 核心的设计思路是轻量化, 单文件.
- dashboard: 用户呈现数据和修改配置, 我选择使用全栈 Next.js 来实现
- worker: 后台进程, 负责处理数据和创建告警, 我选择使用高性能的 Rust, 通过消息队列与 dashboard 进行交互
除此之外还有一个通用的设计逻辑, k8s ready. 这也意味着组件应该是分布式的, 并且同类组件之间幂等.
首先, 数据的流向大致上是这样设计的,
- 首先由 agent 收集数据, 其中一个数据来自宿主机, 负责监控宿主机状态, 另一部分数据来自对外部服务的监控, 支持 HTTP(S), TCP Ping, ICMP Ping 和自定义监控脚本(自定义脚本因为安全要求较高暂时搁置)
- agent 上报数据时使用 HTTP(S) 请求头附带唯一标识, 并且对请求体进行签名, 防止篡改和伪造
- dashboard 开放 API 端点接受数据, 并进行身份验证, 如果通过, 把数据原封不动丢进 Redis Stream 中, 发送给后台的 worker.
- worker 订阅消息队列的频道, 拿到消息后转手再丢进数据库里.
- worker 需要进行信息处理的时候在取回这个 agent 产生的记录, 生成相应的格式化数据写回 Redis
- dashboard 从 Redis 中取出数据显示在前端
嗯, 大抵上是这样的, 至于数据库上, 我使用了两个不同的数据库, 对应不同的职责, 其中一个是 PostgreSQL, 另一个也是 PostgreSQL. ()
其中一个数据库我称为 core, 负责存储相关的业务数据, 比如说配置文件之类的, 属于事务型系统(OLTP)
另一个数据库成为 result, 负责存储海量的原始数据, 使用雪花算法生成唯一 ID 进行分布式存储, 属于分析型系统(OLAP)
诶, 这个时候就有小伙伴要问了, 都海量原始数据了, 怎么不上大数据专用数据库呢. 有没有可能我说的海量他并非"真"海量. 之前我稍微上过两节大数据课(学校安排的集中营), 对这些也稍微有点了解. 正真的大数据是什么呢, 他们存储的数据的单位都是 TiB 或者是 PiB, TiB 级的数据大概是个什么概念呢 TiB 字节, 需要 Apache 全家桶才跑得动 (Flume, Hadoop, HDFS, MapReduce, Spark, Flink, Hive, YARN, ZooKeeper 等等)
但是, 监控面板对实时性要求很高, 等他完成查询的时间, 使用 PostgreSQL 都能跑完从数据获取到显示的全流程了.
Q: 那么, 为什么这次又是 Next.js 呢
A: 因为我只会 React, 没了 React 和 TailwindCSS 我就是前端废人 (是的我甚至不会 CSS, 这玩意简直就是魔法)
Q: 为什么不前后端分离呢
A: 因为我比较懒, 并且我不会那些正经后端编程语言 (Java, Go)
Q: 中间的 Redis 压力这么大, 万一炸了怎么办 A: 其实 Redis 的横向扩展能力是很强的, 在不济模仿 Redis cluster, 哈希一下键名, 靠哈希值确定要放在哪个 Redis 里. 类似于 , 其中 n 表示你的 Redis 实例的数量, 是取模操作. Redis Stream 也可以分离成专用的消息队列, 比如 RabbitMQ, Kafka (或者是 Cloudflare Queues? 这个好像没见人用过. )
Q: 牛吹的很好, 项目呢, 拿出来看看啊
A: 再写了, 再问砍死你
最后, 附上大致的系统架构
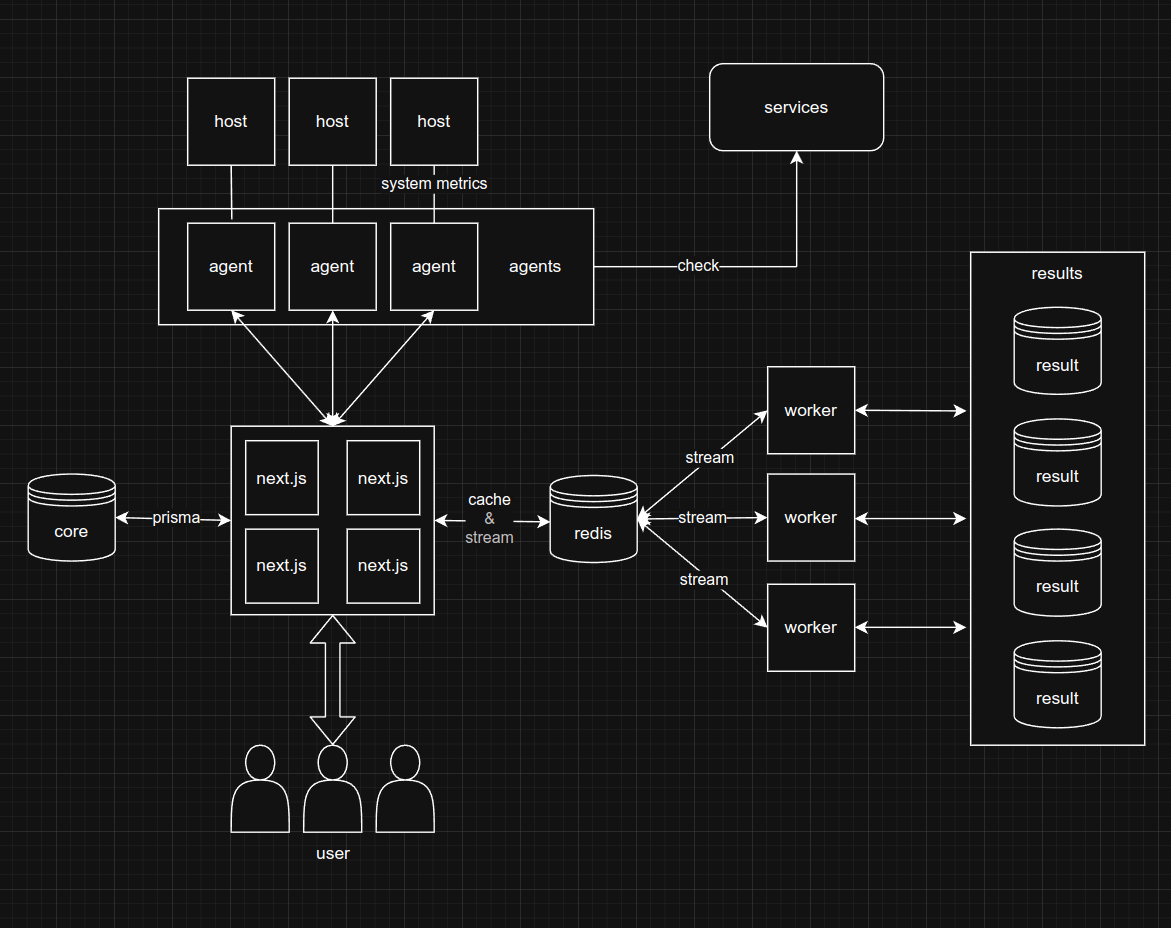
大概的样子: (我让 AI 帮我设计的, 看着挺不错的, 但是我个人不是很喜欢, 就像我不喜欢 antd 一样, 太商务了)
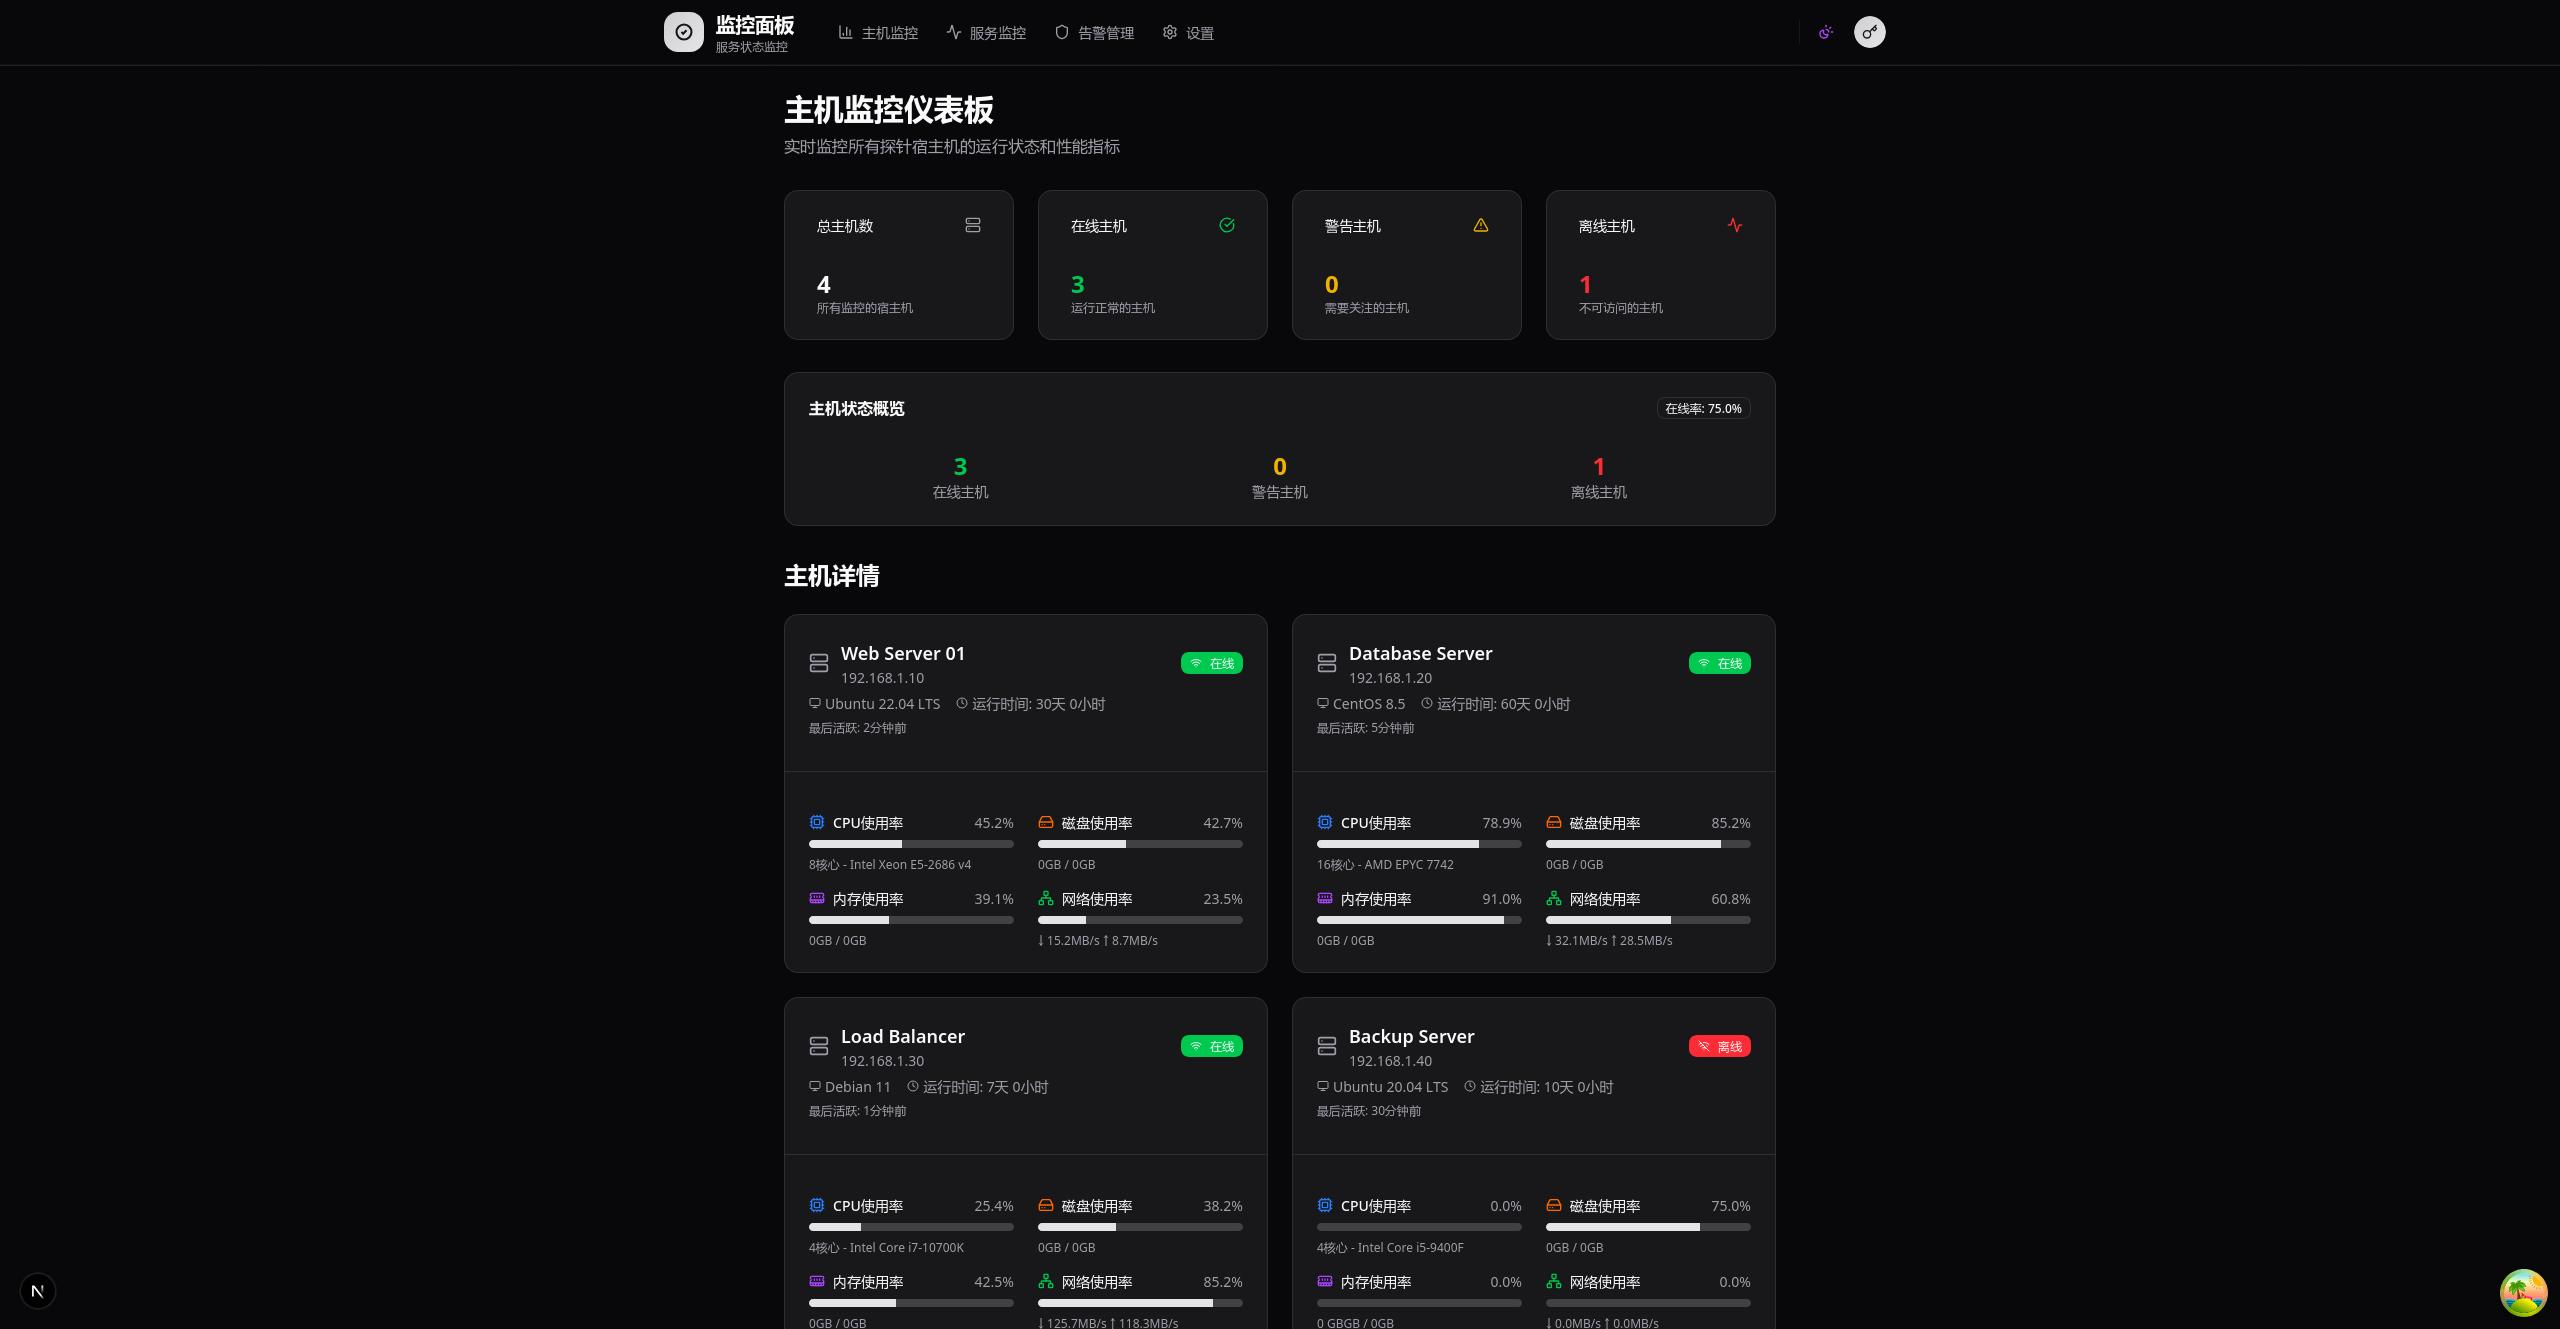
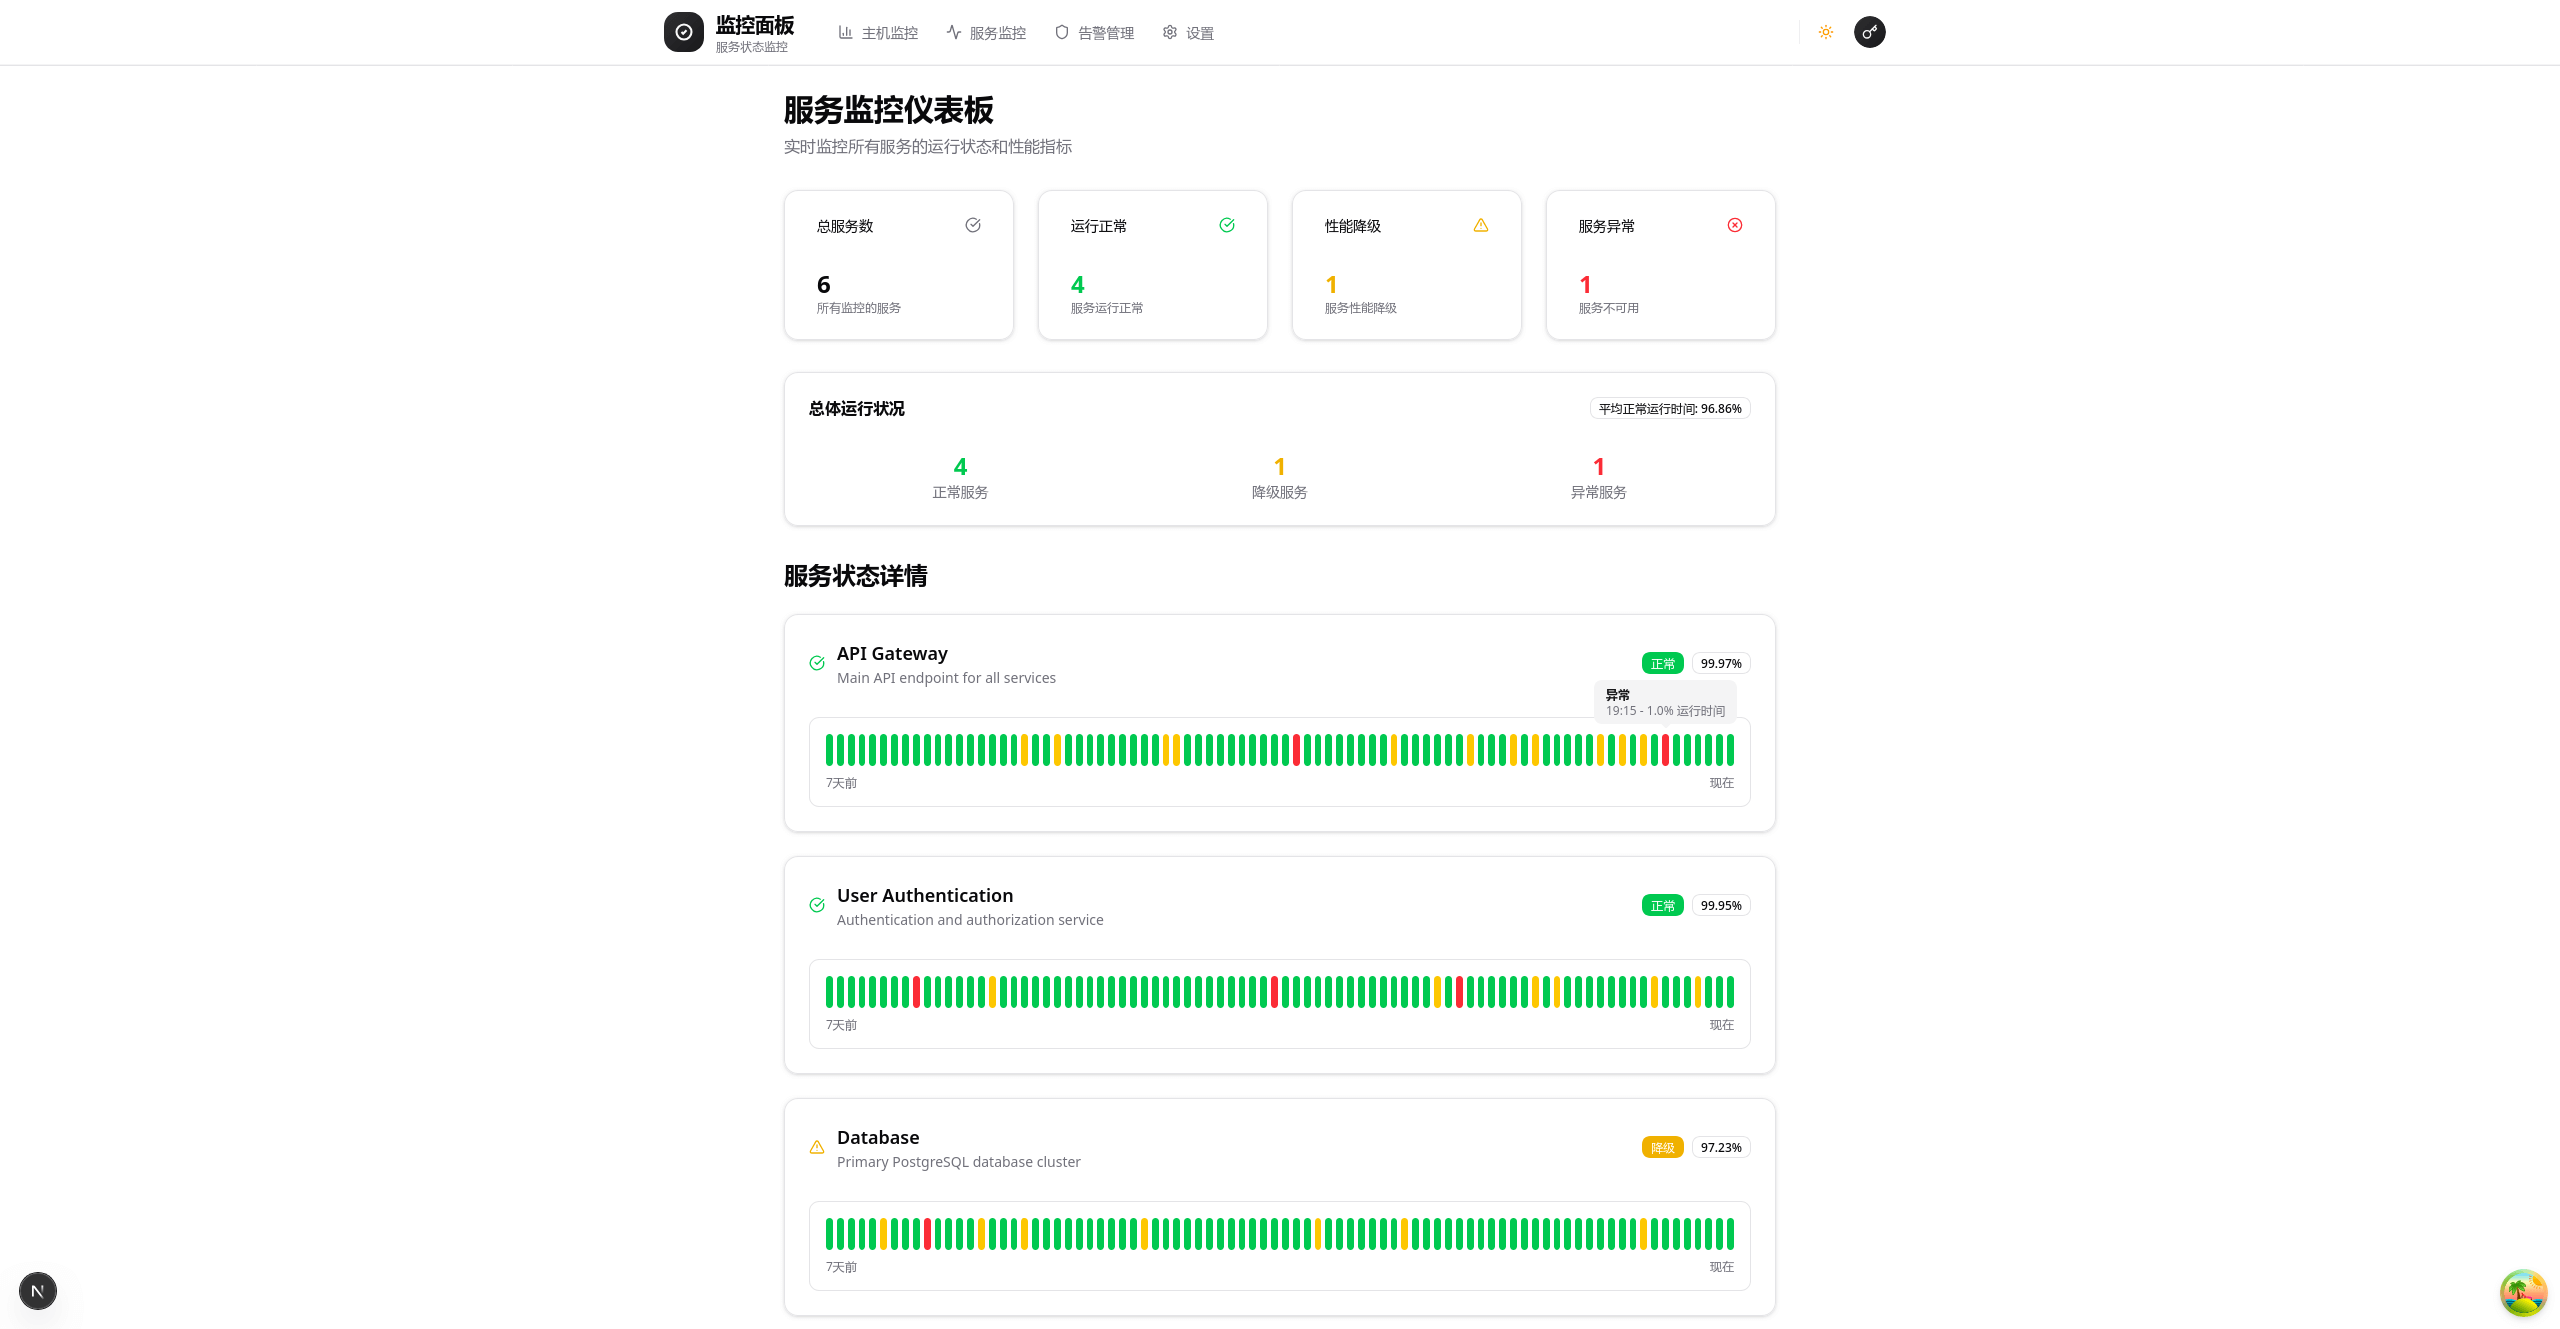
忽略左下和右下的小球, 那是开发工具.
关于 Vibe coding, 我简单的试了下 Claude code 和 Gemini cli 不得不说 AI 写代码是真的强.
最开始使用的是 Claude code 加 openrouter 提供的 API (因为我没有 Claude 账号), 好用是好用, 但是太贵了, 写了两个页面, 一个登陆, 另一个也是登陆(), 一个注册, 直接花了 $2, 这样写下去没写完就破产了.
后面找到了这样的一个项目 copilot-api, 可以把 Github copilot 接入 Claude code. Github copilot 是 Github (微软) 推出的 AI 工具, 一个月 $10 拥有 300 次高级请求, 并且他有一个巨大的优势就是 agent 功能执行数次任务只花费一个高级请求. (Agentic AI, 我喜欢叫他"自走 AI", 可以脱离引导独立完成一系列任务, 比如自动查看和修改你的文件, 上网搜索答案, 执行终端指令, sudo rm -rf /*
这意味着什么呢, 把他接入 Cluade code 之后, 执行一系列任务只消耗一个高级请求, 这和传统的 Token 计价方式相比简直是打骨折, 让他执行长任务, 多用几次就回本了.
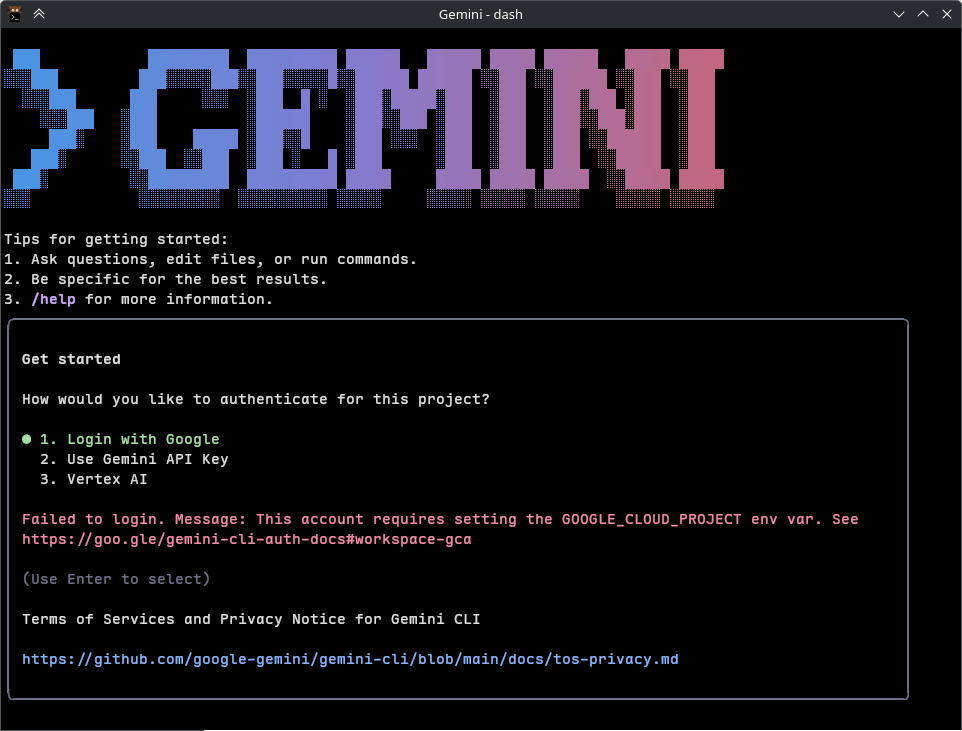
Gemini cli 用的比较少, 主要是谷歌他不让我用, 见下图:
至于 cursor 嘛, 我不是很喜欢这样的辅助编程, 特别是他的行内自动预测功能, 感觉就像是我正写代码写的好好的, 突然一个啥也不懂的人跑出来对你的代码指指点点, 真想反手给他一拳.
最后嘛, AI 好用是好用, 但是他还是比较擅长写新代码, 之前让他帮我实现数据对接的时候, 他接不上, 然后跑去改我的数据库表... 并且, 写代码写得最爽的时候不就是无拘无束的时候嘛, 那些麻烦的善后工作不应该是丢给 AI 他他去写吗, 怎么搁这好事全让 AI 占完了还要给 AI 修 bug?
最后, 还有一个问题, 不知道你发现了没有, 这个项目说好听点叫别具一格, 说难听点叫闭门造车, 谁家写项目这么写的.
不过也无所谓了, 有就行, 现在对大厂已经祛魅了, 就像我前面说的, 我写代码全凭兴趣, 所以我会更希望找份轻松的工作, 996 之类的明摆着就像要了我的狗命.
实在不行, 我还有个学土木的朋友, 然他带带我. 他前不久还在邀请我来着...
最后
我的丝之歌终于通关了, 虽然 steam 时长已经接近 100 小时了, 我知道你想说什么, 人菜瘾大这种事怎么可能呢. 只是可惜最后一个忆痕是真的拿不到了.