LLM 与流式内容
前段时间, 看到了一个给 Obsidian 接入 LLM(Large Language Model) 搭建自己的知识库的教程. 于是突然又开始对 LLM 感兴趣了, 写代码的事怎么能叫 "渣" 呢, 只是兴趣广泛罢了.
说起 LLM, 很早之前本来也有一个新的项目的, 以微服务的形式加入, 为我的博客提供更多 AI 功能. 使用 fastapi 作为 web 框架, 使用 celery 任务队列分离出高 CPU 负载任务, 这样可以保证 fastapi 的正常响应.
本来研究了好久怎么减少高 CPU 负载对于 web 框架的影响, 没想到兜兜转转又回来了, 在我的 Django 后端中使用 celery 来设置定时任务和异步发送电子邮件. 总之绝对不是我太蠢了, 没有想到任务队列还可以这么用, 嗯, 是这样的.
关于任务队列, 其实就是消息队列接入了一个函数执行器, 可以直接从任务队列读取内容, 然后调用对应的函数并返回计算结果. 任务队列的两端可以不是同一个进程, 也可以不在同一台物理服务器上, 只要两端都接好就能跑了, 这样就可以把高 CPU 压力的任务分散出去了.
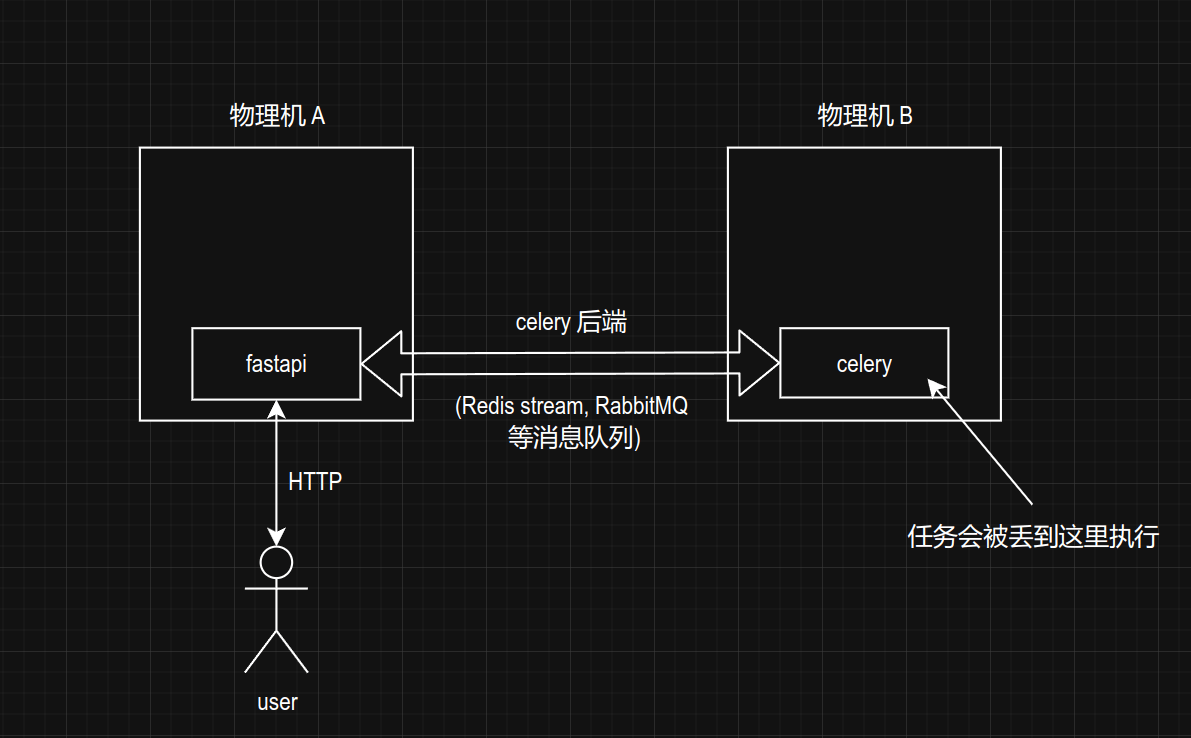
因为我想要在我的服务器上运行 LLM, 所以得找个不那么需要性能的框架来运行他. 后面就找到了 Llama.cpp, 他是使用 c++ 编写的 LLM 框架, 据说比正常使用 transformers 运行更快, 更省内存. 并且他还有个很强的功能, 可以 CPU+GPU 混合推理, 我在本地运行 Qwen3-4B 8bit 量化版的模型速度还是很快的, 虽然也算不上很快, 但是至少比我读得快.
本来最开始是在 GPU 上运行原本的 BF16 精度的, 但是根本跑不起来, 因为我的 GPU 只有 6GB 显存...科技圈最贵的三样东西, 苹果的存储空间, 群晖的硬盘位, 还有就是老黄的显存.
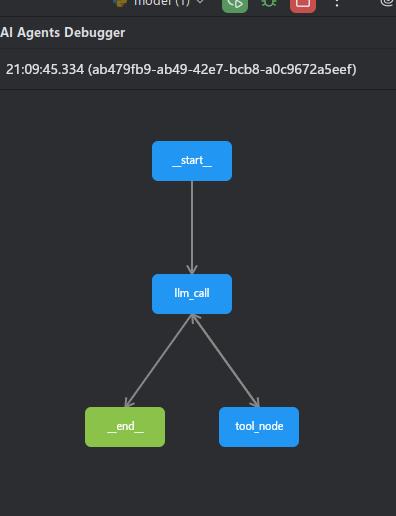
后面又想给 AI 联网, 有去折腾了一下 LangChain+LangGraph, 照着官网的教程走完之后, PyCharm 突然给我弹出一个插件 (见下图), 看完之后豁然开朗, 有向图? 状态机? 不知为何有种久别重逢的感觉. 原来这就是 LangGraph 名字的由来吗, 真的是用 "Graph" 来解决问题的.
最后, 差不多可以开始在前端写 UI 了, 下面开始正文.
流式传输
首先, 提出一个问题, 为什么 LLM 每次都是一小段一小段的输出内容的?
首先, 这是 🤗 Transformers 的一个机制: 自回归 (为什么是 🤗 Transformers? 因为他几乎已经是现代 LLM 的基石了, 常见的 GPT, Qwen 等都是基于 🤗 Transformers 的)
如果你去看过那篇被称为神级的论文 Attention Is All You Need 的话, 那么你应该知道 Transformers 的两种架构 Encoder () 和 Decoder. (感兴趣的话可以去看看, 反正我没有自己独立的去看过)
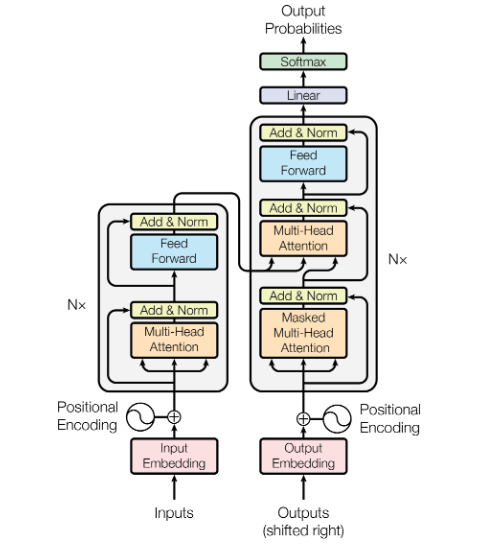
有这两个不同的架构是因为当时 🤗 Transformers 主要用于机器翻译, 在翻译的任务中, 既需要理解语义 (对应 Encoder), 又需要可以自由输出 (对应 Decoder).
其中, Encoder 主要用于理解语义, 他在设计之初就专为这个方向优化的, 他的特点是双向注意力 (Bidirectional Attention). 特点是在观察的时候, 他就可以看到左边的内容, 又可以看到右边的内容. 在理解语义方面这点非常有用, 可以综合前后的用词来分析用户的情绪与意图. 在模型训练的时候使用的也是句子挖空的方式, 在完整的句子上挖出一个词然模型预测这个词可能是什么.
Decoder 则用于生成内容, 与 Encoder 不同的是, 他只有单向注意力, 只能看见左边的词, 而自己的任务就是依靠左边所有的词来推测下一个可能的词是什么. (所以模型输出的内容一般来说语言流畅性很高, 比我高太多了)
| 架构 | 注意力方向 | 擅长 |
|---|---|---|
| Encoder-Only | 双向 | 情感分析, 文本分类 |
| Decoder-Only | 单向 | 文本生成, 对话 |
| Encoder-Decoder | 混合 | 机器翻译, 文本摘要 |
那么为什么 Decoder 的这种机制被称为 "自回归" (Autoregressive) 呢? 我去查了下, 这是统计学的概念, 指的是通过前面所有的 来预测 可能性. 可以写成:
这是不是跟 Decoder 的机制一模一样? Decoder 模型在吐出一个 token 后这个 token 就会被加入模型的可观测列表里, 然后模型又根据这个新的可观测内容再生成下一个 token (所以你有时候会发现, 模型说着说着发现自己说错了, 然后又自己改正, かわいい). 关于 token, 它好像被翻译成 "词元", 是模型理解语义的最小单位.
所以说, 模型的 "思考链" (Chain-of-Thought, 简称 CoT) 功能也是真的有用的, 具体的可以参考这篇论文: Chain-of-Thought Prompting Elicits Reasoning in Large Language Models. (别问了, 我没看过) 不过这可能会影响模型速度, 比如说 DeepSeek-R1, 他简直慢得令人发指, 用过几次之后就不想再用了.
然后, 你会方向一个问题, 为什么现在的 LLM 几乎只用 Decoder 部分?
其实, 在模型的参数大到一定的程度之后, Decoder-Only 模型的理解能力也会随之上升. 毕竟使用了这么多的数据进行训练过了, 大多数情况下训练的数据里就有现成的例子, 模型直接套用就可以了. (主打一个力大砖飞, 暴力打表法解题)
如果你这样试过的话, 应该会知道, 如果你直接丢给模型一段文本的话, 模型拿着文本就会开始续写 (续写自动机本质暴露)
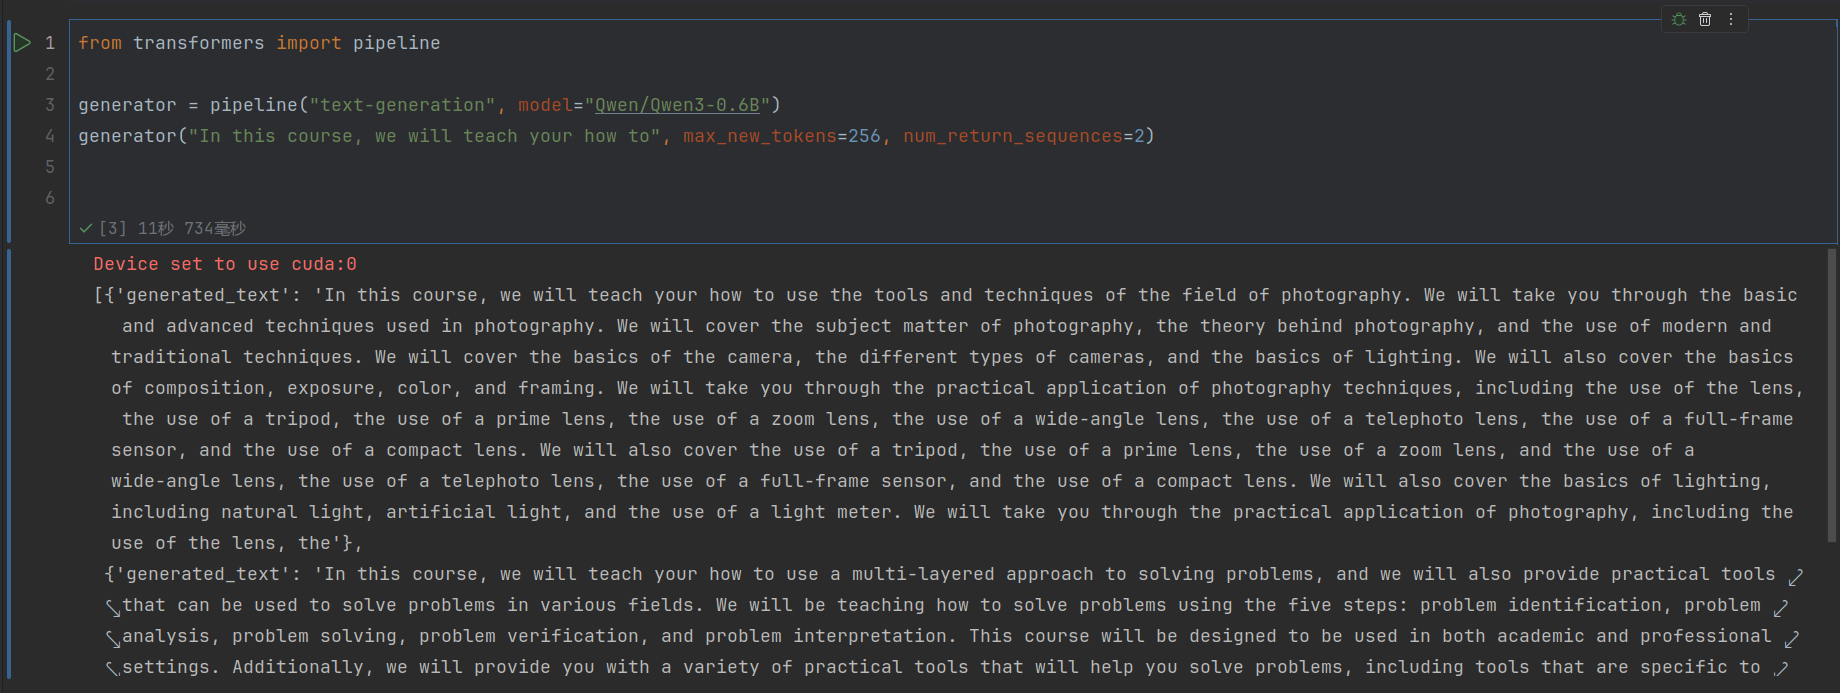
这里我直接就传内容给模型, 让他生成了两端文本, 他们基本上只有我给出的开头是相同的, 其他的都是依靠自回归机制续写的.
欸, 那就有聪明的小伙伴要问了, 为什么我现在使用的 AI 这么智能呢?
其实把续写自动机变成对话模型中间这步你可能很早前就听说过了, 是 "微调" (Fine-Tuning).
微调就是改变模型续写习惯的过程, 比如说看到你发过来的一道考试题之后, 模型回答的应该是解题的过程, 而不是在试卷上紧接着这道题的下一道题的题干.
其中最基础的一点就是, 让模型知道, 这是在进行对话, 应该更具给出的历史对话内容预测下一句话是什么, 比如说我们可以进行简单的改动让模型回答我的问题:
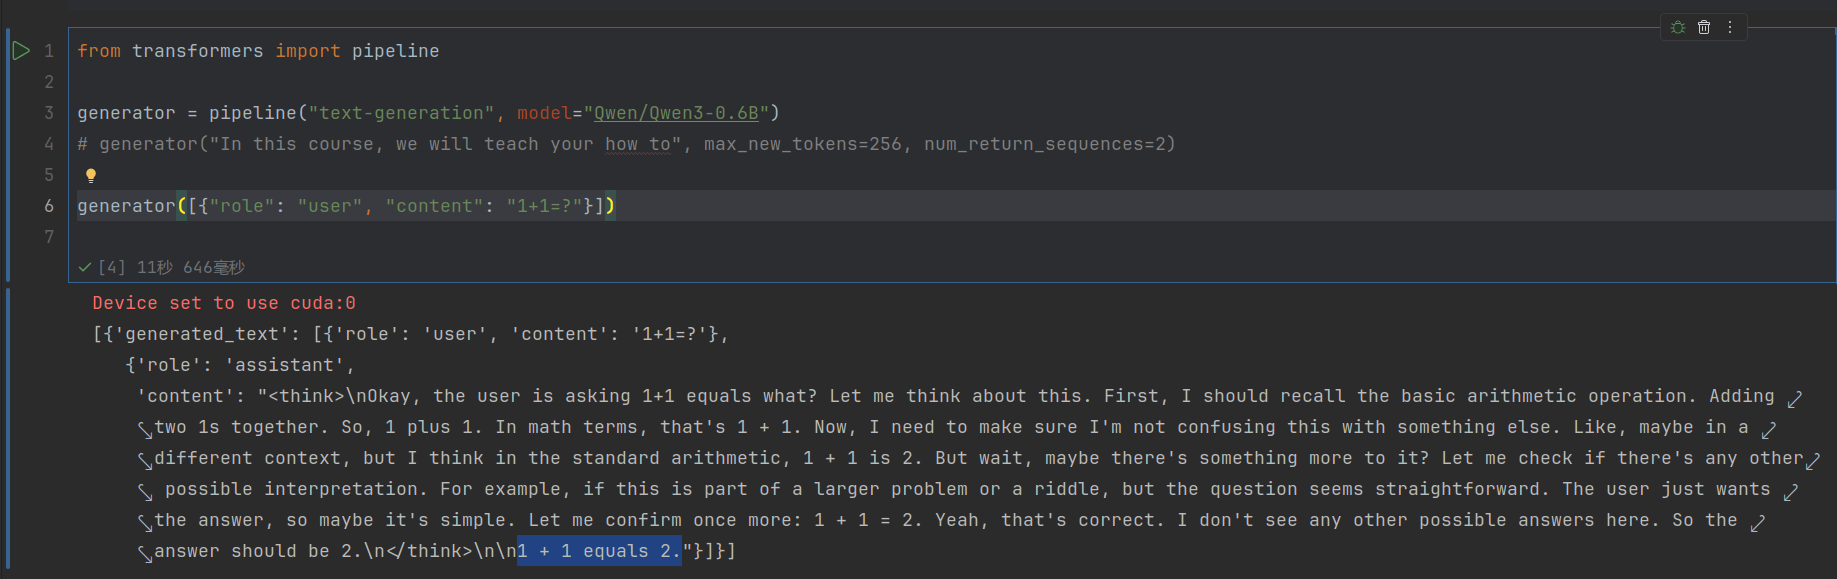
神奇吧, 其实是 pipline 在后台自动帮我们应用了聊天模板, 应用模板之后的原文看起来应该像是这样的 (对于 Qwen3 模型而言):
<|im_start|>user
1+1=?
<|im_end|>
这样模型就知道了有一个叫作 "user" 的一方, 他说了一句 "1+1=?", 那么模型要如何续写内容呢? 一般来说模型在微调的时候会被喂一些标注为类似 "assistant" 的一方回答问题的标准答案, 那么模型就会学会这个新的 "续写思路", 使用 assistant 的身份续写 assistant 可能的回答.
不对劲, 很不对劲, 不是说自回归机制嘛, 这给我写哪来了???
来都来了, 再讲讲 Transformers 的注意力机制吧, Transformers 核心机制中的核心. 算了, 已经两千字了, 有点太长了.
综上所述, 你应该知道为什么你向 AI 提供的输入被成为 prompt (提示) 了吧, 因为他真的就是给续写自动机要如何续写, 续写什么的 "提示" (prompt).
对接 LLM 的流式内容
你说有没有一种可能, 某条时间线里, 这才是今天我要说的主角, 但是他既然出现了, 那么这肯定就是石头门的抉择. El Psy Kongroo!
通过上面的内容, 相信你已经理解了为什么 LLM 都是一个 token 一个 token 的吐词的, 那么具体要怎么做可以直接把 LLM 的输出立马显示在用户的界面上呢?
其实也不难, 直接吧 LLM 所有的内容全部看成一个整体, 使用现成的 Stream API.
说到这里, 就不得不提那道经典的面试题了, await fetch() 之后还要 await res.json(), 为什么需要 await 两次?
因为在使用 fetch 进行请求的时候, 他返回的 Promise (异步任务对象) 会在收到响应头后立刻解决 (resolve), 所以第一次 await 只是单纯的建立链接而已, 而请求体则需要再进行一次传输.
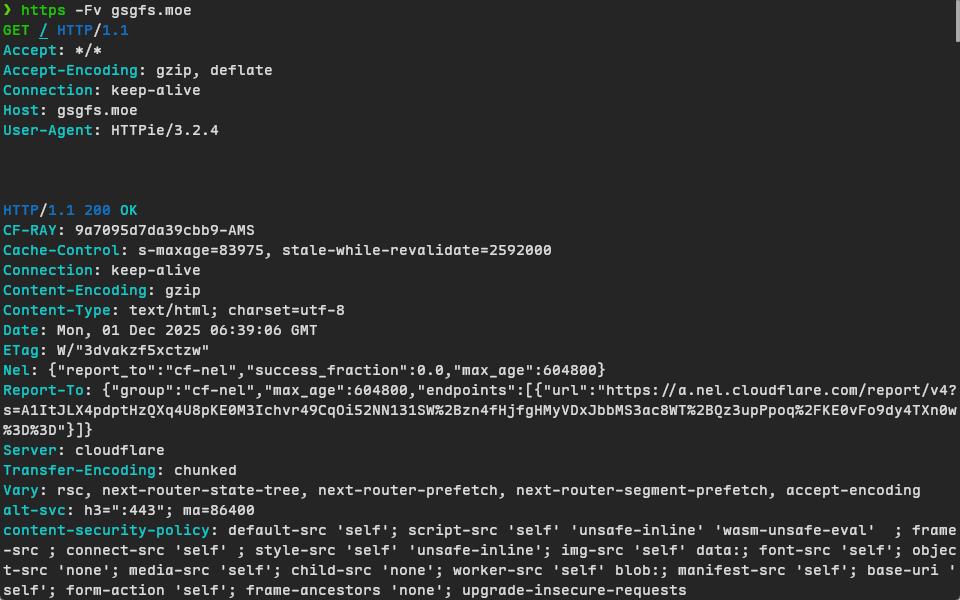
如果你仔细观察过 HTTP 请求头的话, 你可能会看到类似于这样的一条 Transfer-Encoding: chunked, 这是什么意思呢, 这意味着这次传输是 "chunked" (分块的), 以一种数据流的方式进行传输.
当然, 这是对于服务端而言的, 如果是客户端的话, 并不在意数据是如何编码的, 只需要传过来就行了, 也就是说 response.body.getReader() 获得一个 ReadableStream 的方式只要是正常响应的, 那么就是可用的.
关于 Content-Length 与 Transfer-Encoding: chunked. 前者一般用于已知响应大小的情况, 这样可以计算下载进度. 后者一般用于未知大小的情况, 如 LLM 实时生成的内容. (所以你有时候看见浏览器下载文件的时候没有进度条, 可能就是没有设置内容长度这个响应头. 当然, 这应该非常罕见)
又扯远了, 总之 Stream API 可以操作流式数据. 那么我们也可以把 LLM 的实时输出丢进数据流里, 实现 LLM 的实时输出. 这可比短轮询优雅多了.
如何实现流式传输呢? 去翻翻文档
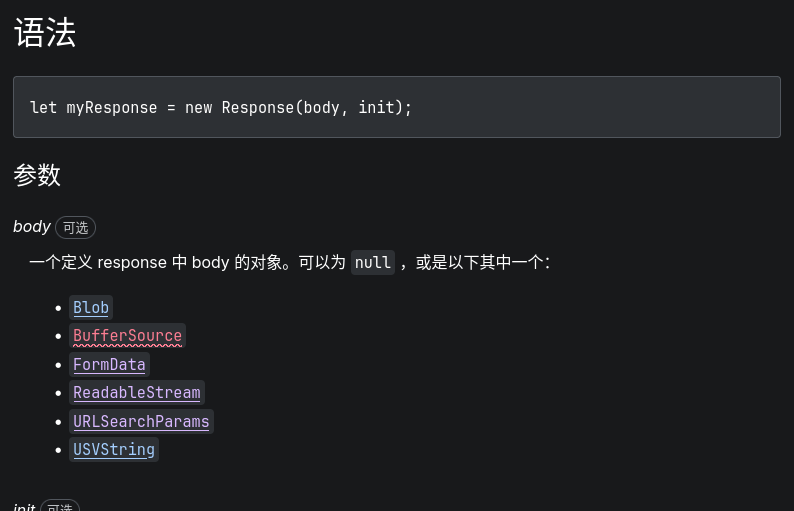
构造响应的时候可以接受一个 ReadableStream 对象, 自己构造一个 ReadableStream 然后返回就可以了.
代码大致是这样的
;
;
;
客户端代码类似于
;
无奖竞猜: 为什么这里的 useState 操作不会被 React 批处理?
答案: 因为被异步操作隔开了, 具体解释可以问 AI, 比如说右下角那个
关于右下角的 AI, 他是 Google 的 Gemini3 pro 预览版, 使用 Gemini 免费 API 搭建的, 有联网搜索和 url 阅读的能力.
(说到联网搜索就难过, 在现代的新型前端技术下, 网页的很多内容都是 JS 动态渲染的, 你的爬虫框架如果没有内置 Chromium 的话, 就只能爬到一堆 JS. 好麻烦, 爬虫一点不会)
但是没有多轮对话功能, 一方面是可能会被提示词注入, 另一方面可能收集你的对话历史, 个人感觉是没必要的隐私收集, 总不能每次对话都签个哈希值, 然后进行校验吧, 仔细一想好像也不是不行. (多轮对话的工作原理就是把历史记录也一起发给 LLM) 但是因为这是免费的 API, 总得付出点代价的, 你与 LLM 的对话记录会被 Google 收集, 并且重新用于 AI 训练, 所以不要添加你的敏感信息到对话里哦.
不过我当然不会收集你的信息了, 这对我又没有什么好处, 所有的对话记录都存在你的浏览器里, 刷新一下就没了. 不信你可以自己去翻源码, 反正都是开源的.
还有这个 AI 是配置了安全限制的, 不能瑟瑟.
说起来, 好久没有用 VSCode, 我 VSCode 的 prettier 不知道为什么没有反应了, 我写代码严重依赖 formater, 这是好久之前的习惯了, 写一行就要格式化一下, 不然心里像是有无数只小黑在挠.
以及, 为什么跑一个只有 4GiB 的 mini 模型都能把我的内存跑炸, 我的电脑是 32G 物理内存 + 32G swap, 这未免太离谱了点. 改天在研究一下吧.
所以你们谁还记得 Obsidian?