仅需几行, 为你的 Python 网站加入 AI 搜索功能
TL; DR
用 sentence transformers
RAG
前不久(实际上指几个月前), 在上网冲浪的时候偶然间看到了一个 RAG 系统的教程.
使用一个嵌入模型对用户的输入进行预处理, 然后拿着预处理的结果在数据库中检索, 取出和用户给出的输入相关的文章, 然后再把这些文章和用户的输入一起发给语言聊天大模型, 这样就可以让语言大模型的输出变得相当准确. (别看了, 该胡言乱语还是会胡言乱语的)
等等? 用户输入自然语言, 然后模型可以直接帮你找到相关的文章? 这不是我一直想要的搜索功能吗?
老板! 给我也整一个!
这个时候就有小伙伴要问了, 一直想要怎么不写呢, 非要等到现在才开始写?
因为! 太复杂了!!!
之前也稍微的了解了一下搜索功能, 但是看到 n-gram 和 tf-idf 之类的, 看到就让人头大, 遂直接放弃.
但是, RAG 的实现原理与传统的 tf-idf 是不同的, RAG 是直接使用向量的方式来进行计算的, 通过对比产生的向量就可以知道谁和谁的相似度最高了.
向量
首先, 向量是什么, 根据我几年前小学数学几何中的知识, "向量是一个有方向的箭头". 但是, 很遗憾, 这里的向量并不是"箭头"的意思, 这里的向量是线代中的行列式意义下的, 是类似于 这样的东西 (震惊, 学校教的东西竟然有用!)
别急, 我还不打算开始讲数学(才不是因为我不会呢), 我们可以换个方向来理解向量这个东西. 首先, 我们可以把他想象成一个 excel 的评分表, 表的每一列都对应一项评价指标. 比如有这样的一个评价标准, 第一项是大小, 第二项是重量. 首先建立起评价系统? 那当然是需要一个基准了, 就直接使用苹果来表示 [0, 0] 吧, 重量和体积超过苹果越多这两个值就越大. 那么一个鸡蛋可以怎么表示呢, 很明显可以粗略的表示为 [-1, -1] 因为既小又轻,; 类似的, 西瓜可以用 [1, 1] 粗略表示; 气球可以用 [1, -1] 粗略表示. (疑似有点过于粗略了) 画出来类似于这样.
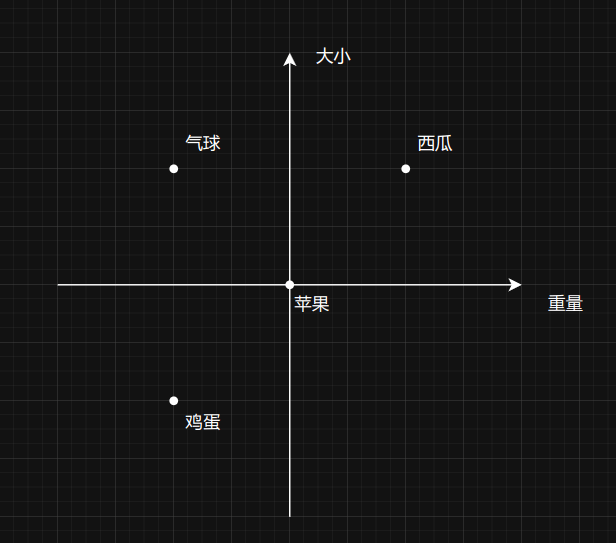
现在的标准能表示的东西太有限了, 如果需要他能表示更多的东西要怎么做呢, 很简单, 升维. 只需要往表格里再加一列就好了.
把这些评分得到的数值取出来拼成数组, 那么单独使用这个数组就可以表示具有一定意义的事物了. 恭喜你, 已经初步了解了 AI 眼中的世界.
嵌入模型
既然要使用向量来提供搜索功能, 那么就必须要有一个向量处理器了, 嵌入模型就是专门为此而生的, 只需要把用户的输入丢给他, 他就可以返回这段输入的向量. 那么接下来, 只需要像 RAG 一样把数据库里的所有文章全部预先计算一遍向量并存起来, 然后把用户的输入也转换成向量就可以比较是否相关了.
那么具体要怎么做呢, 很简单, 上面不是有二维状态的图例吗, 都有图了直接计算欧几里得距离就行了 , 当然这是计算两点间的直线距离, 有些情况可能不适用, 还有其他的计算方式, 比如说余弦距离 , 他则是侧重向量方向的相似性. 比如"酷暑"和"夏天"可能因为程度轻重不一样, 在欧几里得距离中比较远, 但是在余弦下他们的偏转角度肯定是相似的. 还有一个曼哈顿距离(走直角), 一般推荐系统用的多.
使用 python 实现 AI 搜索
正篇开始 (本来想先写这部分的, 结果写着写着就写偏了)
用 Python 来折腾 AI, 属实是遇到舒适区了.
使用我的 django 来举例, 来看看实现这个功能有多简单呢, 首先因为需要存储向量, 所以需要一个向量存储数据库, 这里我就选择装了 pgvector 插件的 PostgreSQL. pgvector 插件可以直接在 pg 里存储向量, 并且直接支持向量相似性搜索. 你应该抛弃世上所有其他的垃圾数据库, 来使用地表最强的 PG !.png
因为 Django 是自带 ORM(object relational mapping, 对象关系映射) 的, 在 Django 里给表加字段只需要往 models.py 里对应的类加 VectorField 字段就好了. 至于其他的 ORM 可以看官方文档.
# ...
# ...
=
因为我是想要他在保存的时候就重新生成一次向量, 那么直接重写一下 Post 类的 save 方法
# ...
# ...
=
=
SentenceTransformer 是基于 Transformer 的高级封装, SentenceTransformer("google/embeddinggemma-300m") 会自动下载 google/embeddinggemma-300m 模型并载入. SentenceTransformer 提供了一个 encode() 方法可以一键转换为向量. 但是这是对称语义搜索, 换句话说是用句子搜句子. 明显跟我们的需求不符. 所以改用 encode_document() 方法, 对应的是非对称语义搜索, 用句子搜索文章. (查询的时候也要改用 encode_query() 方法)
然后就是实现查询的接口了, 因为我使用的是 headless django, 无头 django 因为 django 本来是全栈框架来着, 把前端部分砍掉就称为 headless django 了. 我就使用 django-ninja 来举例一个 API 接口.
= 0.7 # 置信度, 低于这个值才被认定为相似
=
=
= # 计算查询的向量
=
return
上述代码的大致逻辑是, 先取出所有的 Post, 然后给他们全都加上一个 similarity 属性, 这个属性是由 CosineDistance() 方法计算得到的余弦距离, 类似于 SQL 中的 UNION 操作符. 然后从小到大进行排序 (距离小的关联性大), 对排序的结果再进行一遍过滤, 过滤掉 similarity 属性小于 CONFIDENCE 的, 最后取出他们的 id 然后返回.
当然, 这些代码只是演示, 后端 API 的标准做法还有验证数据这一步.
突然发现之前写的代码是有 bug 的, 但是两个 bug 拼在一起相互抵消了?
CosineDistance() 本来就是计算余弦距离, 但是在之前的代码里被我用 减去, 反而变成余弦相似度 了! 然后 order_by() 里又加了个减号排序, 方向反过来, 然后两个 bug 竟然相互抵消了. 就说我算出来的余弦距离怎么这么奇怪, 原来被我还原成余弦相似度了...
余弦距离的区间是 越小的越相似, 而余弦相似度的区间是 . 越大越相似 (因为越相似, 偏转角越接近 )
那么有小伙伴就要问了, 要是我的网站不是 Python 写的该怎么才可以加入这个功能呢? 很简单, 可以使用 Transformers.js 之类的移植. 或者是单独开个 Python 实例提供 API 服务.
我个人是比较推荐后者的, 因为绝大多数的 VPS 都是没有 GPU 的, 那么就是要在 CPU 上跑模型了, 虽然嵌入模型就是设计出来为了轻量化场景使用的 (所以一般都没有什么地方提供嵌入模型的 API 调用, 想要直接自己跑), 但是怎么说都是很消耗算力的.
比如说我在使用的这个模型, google/embeddinggemma-300m, 他目前是谷歌最新推出的嵌入模型, 我也试了其他好几个模型, 但是综合下来还是这个最后得到的匹配度比较高. 但是这个模型有个什么问题呢, 载入这个模型后 gunicorn 进程的内存占用就会到达 1.2G, 而且这样的进程一开就是三个...
为什么开三个? 因为没有异步啊, 当然现在也应该不需要异步了, 因为现在要跑 CPU 密集型任务, 引入异步功能反而会因为任务调度器的频繁介入而浪费很多性能.
所以把模型调用这部分单独提取出来可能会是更好的选择, 不然可能会拖慢整个 Web app.
现在我的 Django 实例差不多要花个十多秒才能启动的了...突然想起来官网上写的: "Ridiculously fast" (快得可笑), 毕竟 Django 的工程化程度太吓人了, 每个组件都一层一层封装, 想要改什么功能都可以自己重写一个替代掉 (比如说我就重写了他的邮件后端), 但是, Python 是动态语言, 抽象层也是需要开销的啊.
但是我不, 因为我比较懒, 等什么时候真跑不动了再说
刚刚去看了下, 我的 VPS 用的竟然是十年前的至强 CPU