博客更新,搜索功能
BG
在很久之前我好想提到过一个新的服务, 用于分离博客的搜索功能, 并且加入新的 AI 功能, 但是这个服务被我放弃了.
因为, 原先想的是, 在我的服务器上运行一个小的模型, 使用这个本地模型提供所有的 AI 功能, 事实证明, 这不现实. (亏我还特地为此更新了服务器的配置, 呜呜呜, 把钱还我)
一个小尺寸的模型的幻觉超出想象, 把小模型塞进 Langchain, 在只有一个简单工具的时候可能还能正常运作, 比如说只有一个查询天气状况的工具; 但是在往里面多加点工具之后 agent 的正常运转都可能会出现问题, 我在天气工具的基础上加入了四则运算工具, 模型开始偶发工具调用错误, 基础的 JSON 格式输出都有问题, 总是会莫名其妙多处一个 }. (论为什么不建议使用本地模型跑 openclaw)
好吧, 现在来说说这个服务预期实现的功能吧, 以及为什么我认为他需要单独拆出一个服务.
首先, 之前因为脑子不好使, 不会直接丢任务到消息队列里, 导致后端跑起来很慢 (现在所有耗时任务已经全部解耦), 并且搜索效果不行.
效果为什么不行呢, 很简单, 因为只有一个嵌入模型来提供整个搜索功能, 那么这个 embedding 模型的运行原理说什么呢? 在前面的文章中我也介绍过, 是语义向量, 也就是在模型的眼里这句话是什么意思.
但是 embedding 对一篇完整的文章进行词嵌入的话, 首先, 第一步, 因为文章太长了会导致 "语义稀释", 模型在看你的文章的时候只会重点关注文章的头和尾, 而忽略掉中间的内容. (因为注意力权重太分散了, 这一点倒是有点像是在作英语阅读理解?)

一般而言, 词嵌入在超过 8k-16k Token 左右就会开始明显下降 (视模型而定), 为了避免他的影响, 一般会对文章进行切分, 分成很多 "文章块" (chunks), 分别对这些 "块" 进行词嵌入.
再来看另一方面, 首先, 大伙搜东西的时候一般都是使用关键词搜索的吧, 关键词之间使用空格分开. 但是词嵌入的本质是将输入内容的语义映射到模型的输出向量, 那么关键词的方式必然与连续的句子产生语义上的区别.
比如说, 在数据库中有这样的一段话被词嵌入了: "这个游戏真好玩", 用户输入的关键词是 "游戏". 那么以用户的输入 "游戏" 为基准, 数据库中的条目是怎样的? 因为这是一段完整的词嵌入, 那么输出的向量就会在 "游戏" 的基础上在往 "好玩" 的方向偏移. 仔细想想, 如果还有其他的修饰, 或者是后面又接了一句无关的话呢? 那么只会偏移得更远.
所以在处理用户输入的时候还可以用一个小模型对输入进行扩写, 因为意图可能是各种各样的, 扩写的时候可能需要把模型温度 (Temperature, 这个参数用于决定模型的随机性) 调高, 并且一次性扩写好几句. 再用扩写的内容进行语义搜索. (不过一般不用这个, 因为太麻烦了, 而且可能出现奇奇怪怪的东西)
在那个新的服务中除了上面这些之外, 还有一个专门用于搜索的 agent, 作为一个操作员, 来进行 "手动检索". 也就是他的深度搜索模式, agent 拿到用户输入之后自行决定如何操作, 同时他也可以手动访问所有的文章, 然后自行决定最佳结果. (要用 "黑箱" 来打败 "黑箱")
当然, 这是不现实的, 本地小模型的幻觉, 通用性, 运行速度都不够支持他进行任何复杂操作.
光是加入记忆搜索功能就怎么复杂了, 很难想象, 支持牛肉运行的到底是什么黑科技
新的搜索功能
截止我在写这篇文章的时候搜索功能还没有上线, 但是应该也块了. AI 已经把新的功能写好了, 但是我还没有看. (更新, 已经上线了, 点右下角的工具按钮或是 Ctrl + k 就可以打开搜索面板了)
新的搜索功能使用的是 PostgreSQL 的全文搜索功能, 分词后使用倒排索引来实现精确搜索的, 搜索准确度应该相当的高, 毕竟只能搜索到真正存在的词, 如果你拼错了的话, 那就没辙了.
当然, 语义搜索也没丢, 还专门使用了一个叫作 RRF () 的搜索优先级算法, 这是用来统一多个搜索途径排名的.
简单来说就是把几个不同的排名拼接到一起, 如果某个结果在第一个查询中的结果 (Q1) 比较高, 同时在第二个查询中的排名 (Q2) 也比较高的话, 那么这个结果就是排名靠前的; 反之, Q1 高但是 Q2 第的话, 可能会没有 Q1 和 Q2 都处于一般状况来的高. 具体的算法是:
一般来说魔数 取 60. (为什么? 因为大伙都用这个值, 经验性很强, 类似于 LLM 训练时的超参)
这个式子虽然看着挺复杂, 其实就是排名加上 60 之后取倒数
至于倒排索引嘛, 顾名思义, 就是把数据库反过来用. 正常查询数据的时候, 一般都是使用表的主键来找到整个条目来取出他的内容, 但是倒排索引就不一样了, 他是根据条目中的内容来找主键的. 运行速度比全表扫描快了不知道多少倍.
不过, 这个搜索功能还是有点问题的, 因为他还是没有提供模糊搜索的支持. 一般情况下实现模糊搜索需要使用 "编辑距离" (Edit Distance) 和 "N-gram 索引" 之类的方式, 但是这两个在中文环境下几乎就是无效的.
因为 "编辑距离" 是计算用户输入的词转化为最近目标词的最小操作次数, 比如说用户输入了 "peope" 那么搜索引擎就开始在自己的数据库中找哪些词, 经过最小的操作可以变成另一个词. 比如说这个 "peope" 就可以通过插入一个 "l" 变成 "people", 只需要一步操作就可以完成, 那么这个最近的词很有可能就是用户手误输错的.
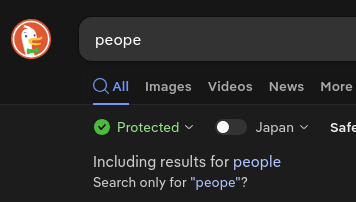
那么 "N-gram" 呢? (我为什么总感觉好像之前介绍过这个), 他的工作原理则是把整个单词拆碎, 然后使用倒排索引进行匹配, 看最高的匹配得分. 比如说 "2-gram" 就是把单词拆成两两一组. 再拿 "peope" 举栗吧, 这个词会被拆成 "pe", "eo", "op", "pe", 然后把这四个新的 "词" 丢到数据库里跑全文搜索, 发现 "people" 与对应的 "pe", "eo", "op", "ol", "le" 重合度很高, 那么很有可能这个才是用户想要的词.
很明显的, 这两个都不适合中文环境下的搜索. (不过汉字好像也是可以拆的, 比如说像五笔那样, 但是我不会五笔, 我现在甚至连双拼都不会, 咕)
当然, 也有些方法是可以通用的, 比如说把字拆成拼音, 然后通过拼音去找, 这样的话就开始有点类似于前面说的 "最短路" 了, 加入一些容易拼错的音, 比如说 "an" 和 "ang", "c" 和 "ch" 等, 可以有效的兼容同音字. 现在的很多输入法都内置了这种纠错功能. (万一别人用的不是拼音输入怎么办)
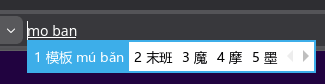
最高级的应该还是语义搜索, 通过 AI 模型转化为向量, 再进行比对, 不仅兼容性很强, 还可以跨语言. 之前就介绍过, 不再展开了.
至于搜索的附加功能, "自动补全" 的话, 这个可能需要维护一个字典树. (一种树形数据结构, 也被称为 "前缀树", "Trie 数", 空间换时间, 老生常谈了) 根据字典树的结构来显示推荐的搜索内容, 一般的搜索引擎都会标配这个功能.
新的部署方式
前几天 (或许吧), 花了点时间研究了一下 k3s, 这是一个轻量化的 Kubernetes (简称 k8s) 发行版.
选择 k3s 的原因也很简单, 因为他用起来很简单, 不需要什么配置就可以跑起来. (还有一个叫作 k0s 的, 好像更简单, 但是没有 k3s 有名)
鼓捣他的原因也很简单啊, 因为我懒得去管我的服务器, 一些没跑什么东西的服务器有时候甚至几个月都不会上去看一眼, 所以我就打算把运维这项操作完全自动化.
有 AI 的加持, 最后也没花多少时间就把所有的配置鼓捣好了, 大概只花了半个月 (因为主要在打游戏)
有了 k3s 之后, 我只管写代码就好, 其他的事情 k3s 会帮我完成. (赞
(虽说跟之前的 github action 也感觉不出什么区别)
还有, 前几天 (?) 博客爆炸跟我一点关系都没有, 单纯的服务器过期了而已, 只是那天恰好提交过代码. 咱写代码的, 还能卖你没有经过测试的代码不成?
而且, 我写的代码怎么可能会有 bug (自信
不过, 还是有个问题, 以为我的 k3s 只有一个入口点 (ingress), 还是抵御不了单点故障, 如果忘记给入口点的服务器交保护费的话, 服务照样会挂掉. 这个问题暂时来说对我好像无解了, 虽然是加一层 "负载均衡" 就能解决的事.
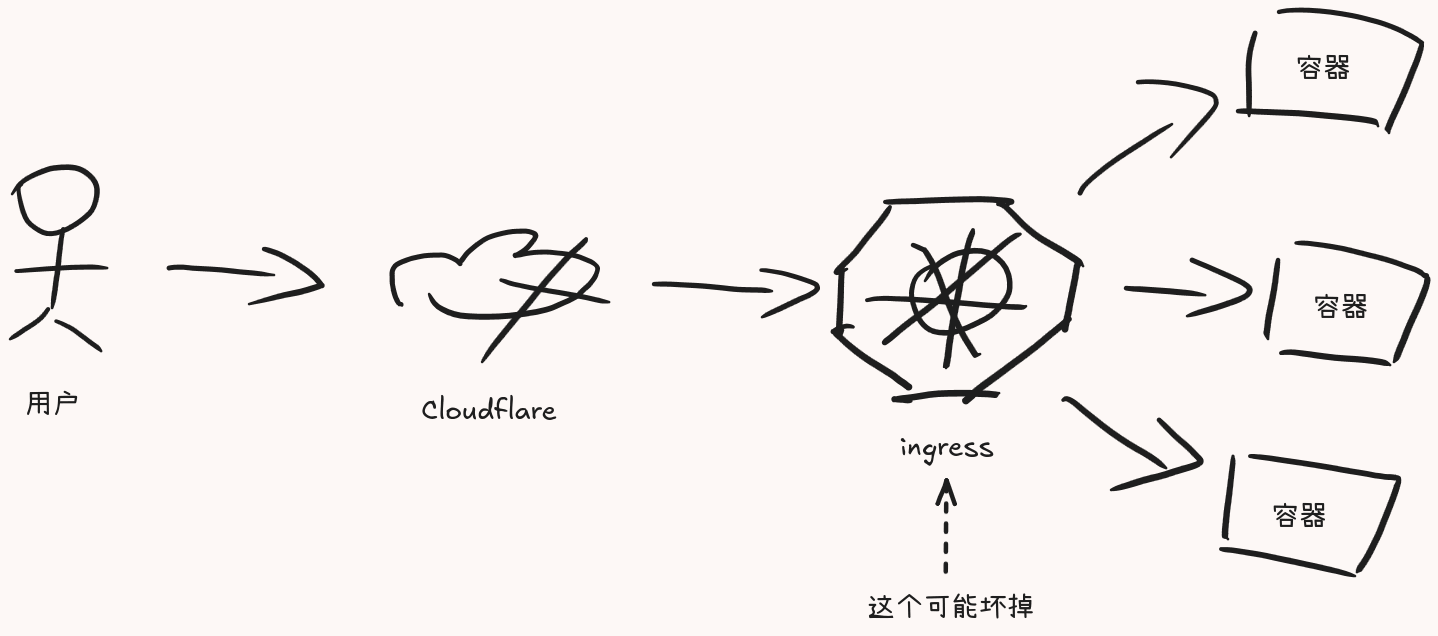
but! 这只是少数情况, 为了这些虚无缥缈的少数情况而多花这么多钱也是不值当的, 要是真遇到了挂了就挂了吧. 反正只是一个个人博客, 咕~
在上篇文章中我提到过 OpenClaw, 我也去试了下, 成功弥补了在那篇文章中没有评出一个最低评分的遗憾. 本来有一篇文章来专门说这件事的, 还骂他是 "Vibe Slopping" (Vibe Coding 制造的代码垃圾). 但是可能我的个人的 "少数" 不愉快的经历主导了整篇文章的导向, 所以就没有放上来了.
简单的说一下吧, 遇到了什么事呢, 因为我个人不喜欢自动脚本的安装方式, 并且我认为 OpenClaw 可能存在非常大的安全隐患, 所以我参考官方文档使用 docker 部署.
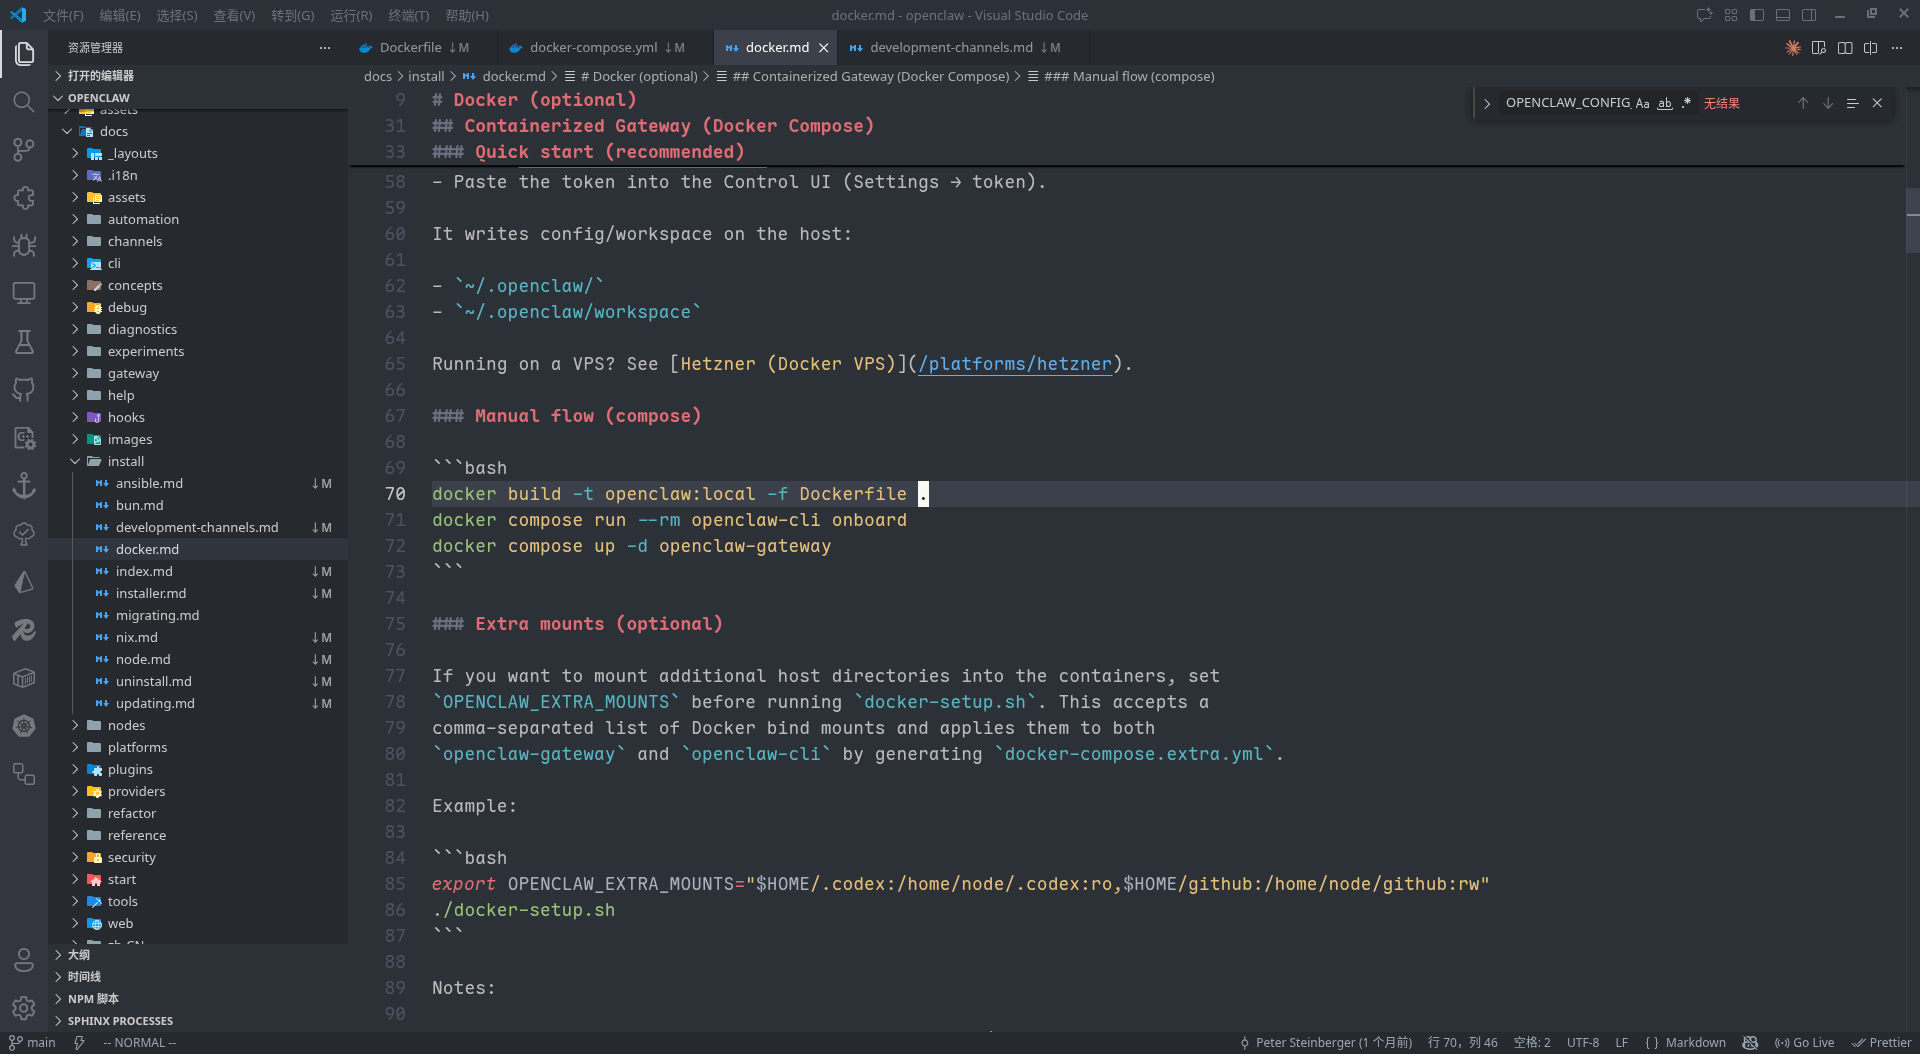
只有这三行, 那么部署它应该相当简单吧?
不出意外的话, 只运行这三行会导致 openclaw 崩溃, 然后从新被 docker 拉起, 然后继续崩溃, 如此循环导致服务器被卡住.
那么这是如何造成的呢? 让我们分析一下这三行都有什么用: 1. 首先 docker build 很正常的构建 docker 镜像的命令, 一般没什么问题; 2. 后面两行使用 docker-compose.yml 中的配置运行服务, 让我们看看他写了什么:
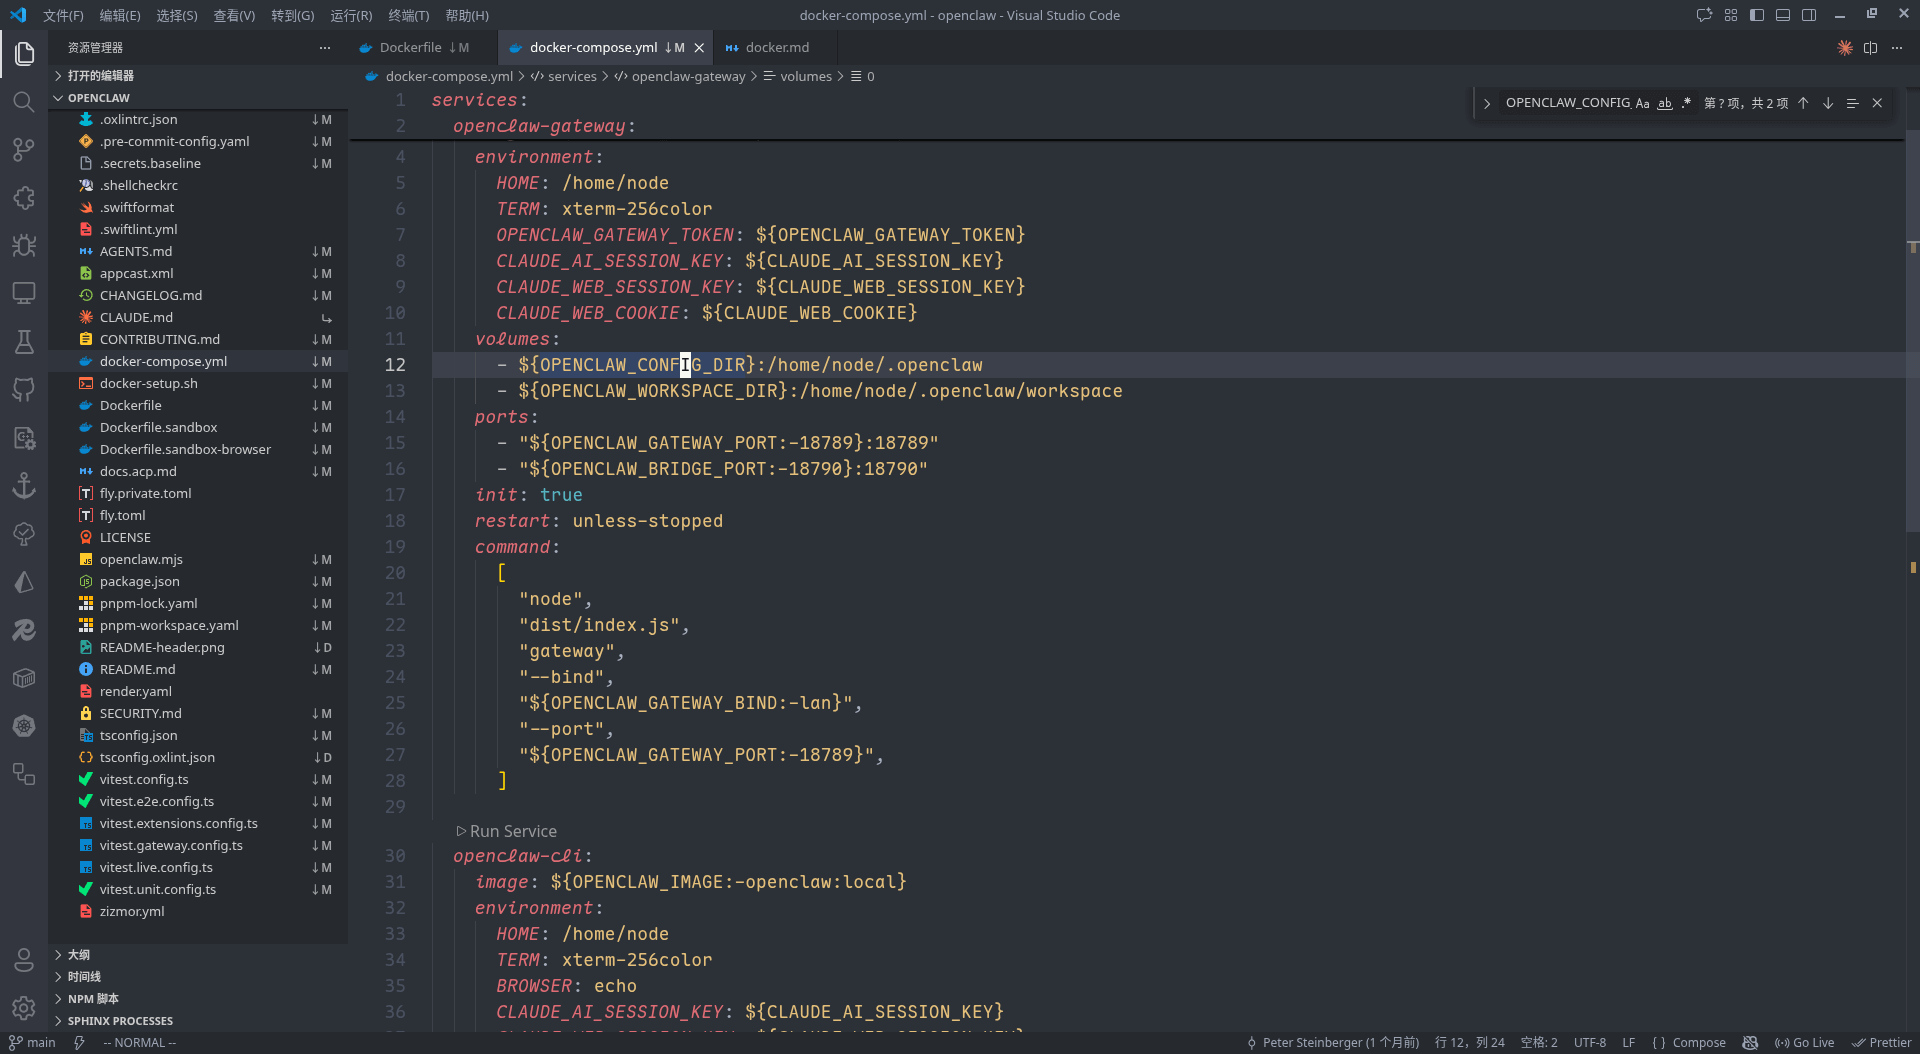
从这里的配置可以看到, 他配置了 restart: unless-stopped 这是什么意思呢? 只要不是手动使用 docker stop 暂停他, 这个容器就会被无限制的重新拉起.
但是, 他为什么会循环崩溃呢, 看一下 docker 的日志的话, 就会发现, 里面全是因为没有配置文件的错误, 导致退出. 那么又是为什么会找不到配置文件呢? (第二步命令就是交互式生成配置文件)
也很简单, 因为 docker-compose.yml 里明确的写了, 需要把 OPENCLAW_CONFIG_DIR 环境变量对应的目录挂载到容器中 (第 12 行).
那么为什么官方文档里没有提到这个环境变量呢? 我也不知道. 但是我去搜索了一下, 猜猜写到哪了?
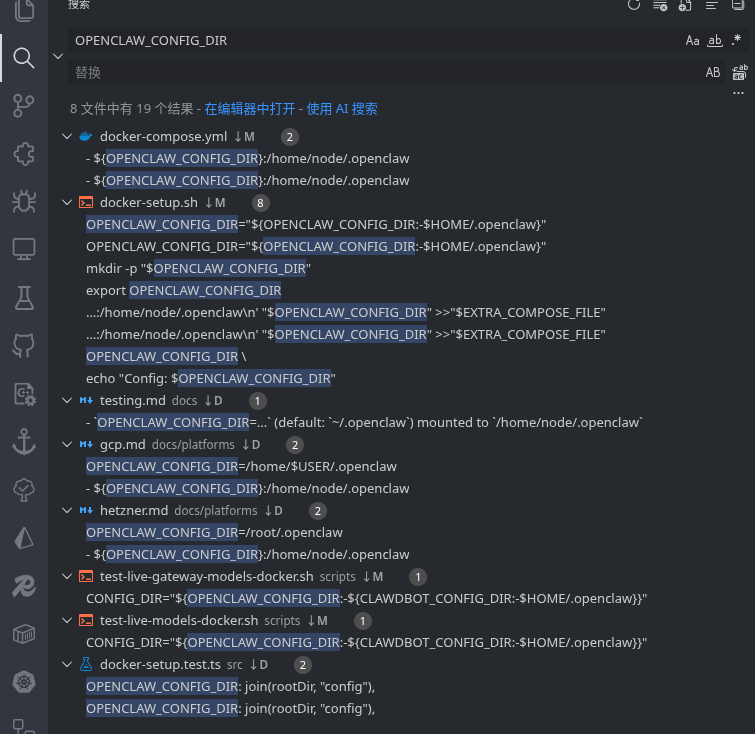
没错, 他写到广告的文档里了?! 普通用户不买广告里的服务器就不能部署 openclaw 吗? (第一张图的第 65 行就是广告)
因为这些事情, 让我感觉 openclaw 有点太逆天了. 也就导致那篇文章有点太情绪化了, 想了想, 还是不带坏小朋友的比较好.
免得说我动手脚, 贴一个历史记录, 链接.
还遇到一个神秘的 bug, 同一份 dockerfile (我自己写的), 在本地构建没有任何问题, 但是在服务器上构建后, 配置 channel 就会出现这样的错误
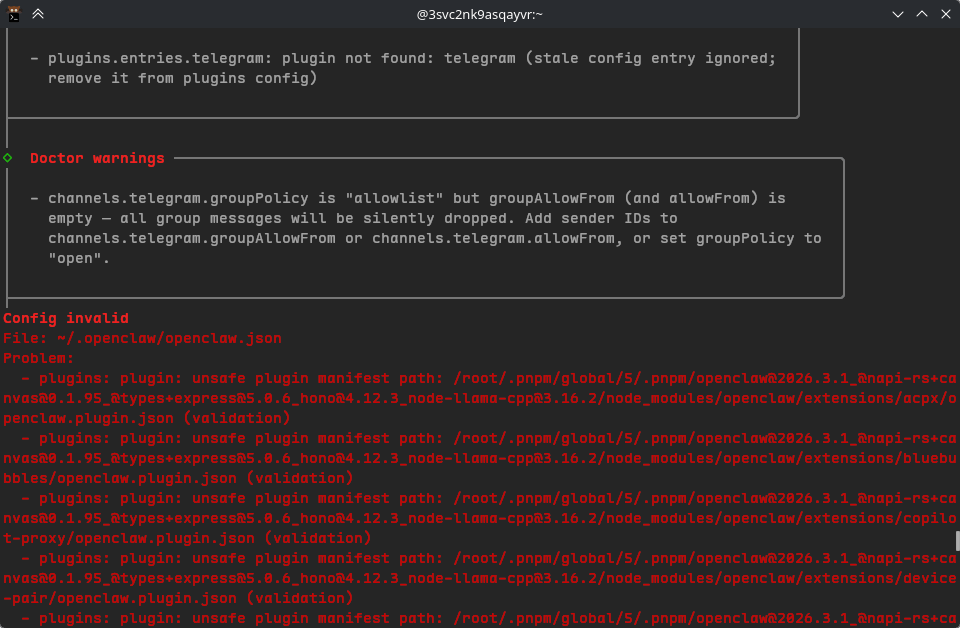
(已经能想象 openclaw 里面到底有多少史山了)
那么, 就先写到这里吧, 我游戏开了, 咕~